VEIRA Vocal Remover

Nimm den Gesang aus einem Song, behalte nur den Gesang oder mach ihn lauter oder leiser, mit KI auf deinem Computer.

$29.99, ein einmaliger Kauf mit kostenlosen Updates

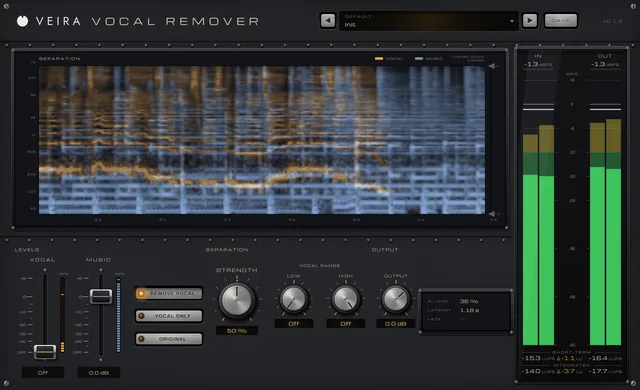
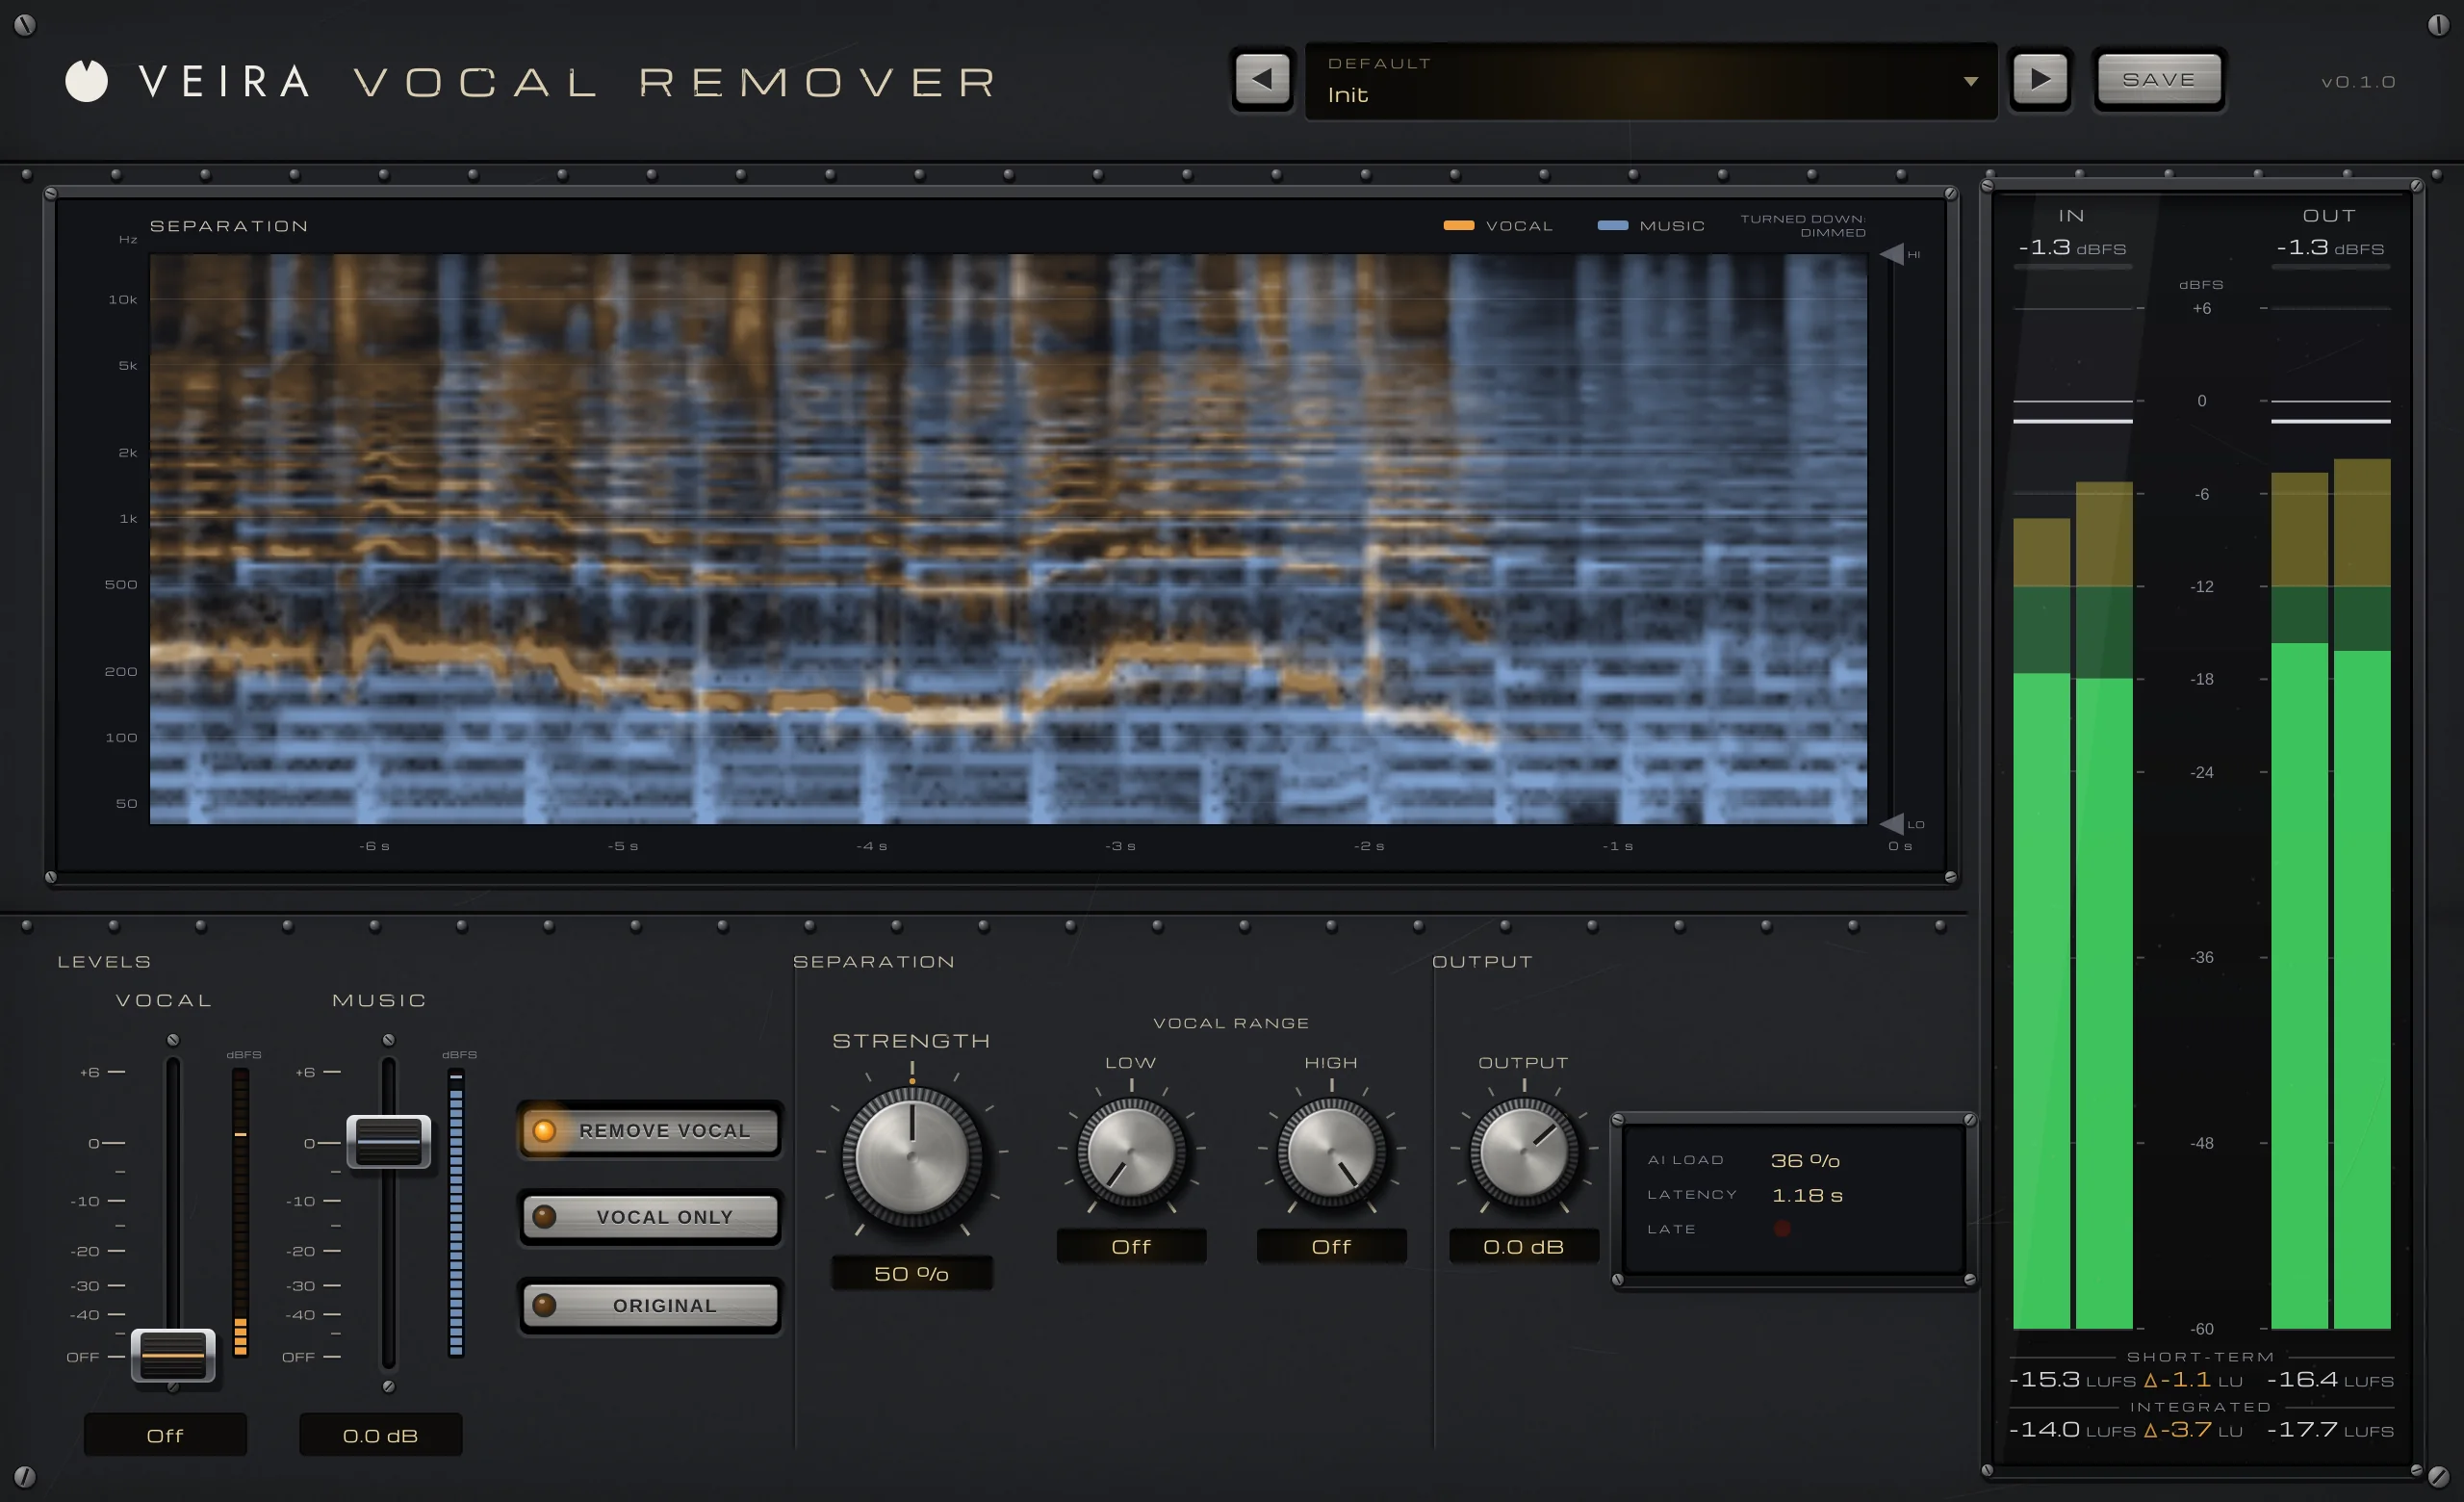
VEIRA Vocal Remover mit dem Preset Init, während ein Song läuft: das SEPARATION-Display mit dem Gesang in Bernstein über der Musik in Blau, die Fader VOCAL und MUSIC mit leuchtendem REMOVE VOCAL, STRENGTH und die VOCAL-RANGE-Regler, OUTPUT mit AI LOAD und LATENCY sowie die IN- und OUT-Meter mit Lautheit.

VEIRA Vocal Remover nimmt den Gesang aus einem fertigen Song, behält nur den Gesang oder macht ihn im Mix lauter oder leiser. Ein KI-Modell hört den Song und zerlegt ihn in Gesang und Musik, und zwei Konsolen-Fader, VOCAL und MUSIC, bestimmen, wie laut jeder Teil zurückkommt: ein Karaoke-Track oder ein Instrumental mit einem Klick, ein A cappella mit einem anderen oder ein Gesang ein paar dB lauter oder leiser in einem Song, den du nicht öffnen kannst.

Der Unterschied: Es läuft auf deinem eigenen Computer, in jeder DAW, ohne Upload und ohne Internet. Das Modell ist Spleeter vom Forschungsteam von Deezer, in Echtzeit vom eigenen Code des Plugins ausgeführt. Mit beiden Fadern auf 0 dB geht der Song Bit für Bit durch, STRENGTH und die VOCAL RANGE steuern, was die KI nehmen darf, und das SEPARATION-Display zeigt, was sie hört. Es hört etwa 1,18 Sekunden voraus, was deine DAW bei der Wiedergabe ausgleicht, und funktioniert am besten mit gesungenen Stimmen.

Ein Rundgang durch VEIRA Vocal Remover

VEIRA Vocal Remover mit dem Preset Init, während ein Song läuft: das SEPARATION-Display mit dem Gesang in Bernstein über der Musik in Blau, die Fader VOCAL und MUSIC mit leuchtendem REMOVE VOCAL, STRENGTH und die VOCAL-RANGE-Regler, OUTPUT mit AI LOAD und LATENCY sowie die IN- und OUT-Meter mit Lautheit.
  1. VEIRA Vocal Remover im Überblick

    VEIRA Vocal Remover zerlegt einen fertigen Stereo-Song in seinen Gesang und alles andere, mit einem KI-Trennmodell, das im Plugin auf deinem Computer läuft. Zwei Konsolen-Fader, VOCAL und MUSIC, bestimmen, wie laut jeder Teil zurückkommt: VOCAL aus für einen Karaoke-Track oder ein Instrumental, MUSIC aus für ein A cappella, alles dazwischen, um einen Gesang lauter oder leiser zu machen. STRENGTH bestimmt, wie entschieden das Modell festlegt, was Stimme ist, die VOCAL RANGE hält Kick, Bass und Becken heraus, und das SEPARATION-Display zeigt den Gesang in Bernstein und die Musik in Blau.

  2. Was die KI hört

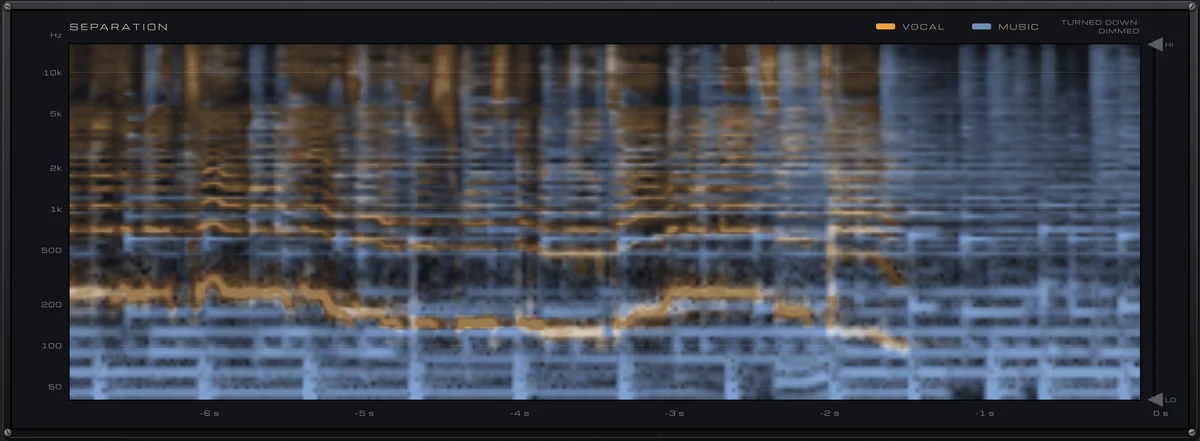
    Die letzten sechs Sekunden des Songs nach Tonhöhe: der Gesang in Bernstein, die Musik in Blau, ein leiser gemachter Teil blasser.

  3. Gesang und Musik

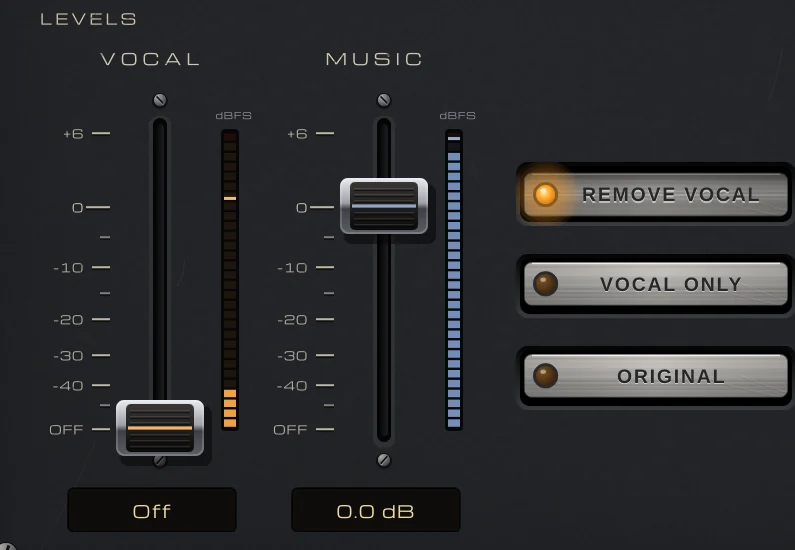
    Zwei Fader, Off bis +6 dB, mit je einer Pegelsäule; ein Klick für REMOVE VOCAL, VOCAL ONLY oder ORIGINAL.

  4. Trennung

    STRENGTH bestimmt, wie entschieden die KI festlegt, was Stimme ist; die VOCAL RANGE hält Tiefen und Höhen heraus.

  5. Ausgang und Status

    OUTPUT, wie stark die KI arbeitet, die Latenz, die deine DAW ausgleicht, und die LATE-Lampe.

  6. Ein- und Ausgang

    Peak und RMS für Ein- und Ausgang, mit Short-Term- und integrierter Lautheit.

Was VEIRA Vocal Remover für dich tut

Die Tasten REMOVE VOCAL, VOCAL ONLY und ORIGINAL, REMOVE VOCAL leuchtet.

Nimm den Gesang heraus oder behalte nur ihn

Zwei Konsolen-Fader bestimmen die beiden Teile: VOCAL für die Stimme, die die KI findet, und MUSIC für alles andere, jeweils von Off bis +6 dB. REMOVE VOCAL, VOCAL ONLY und ORIGINAL setzen beide mit einem Klick, für einen Karaoke-Track, ein Instrumental oder ein A cappella. Gemessen an Testsongs mit bekannten Spuren lassen die Karaoke-Presets den Gesang 19 bis 23 dB leiser und die Musik innerhalb von 0,6 dB, und die A-Cappella-Presets halten das Übersprechen der Band 20 bis 27 dB darunter.

  • Gesang 19 bis 23 dB leiser
  • Musik innerhalb von 0,6 dB
  • Einstellungen mit einem Klick
LEVELS: der VOCAL-Fader auf Off und der MUSIC-Fader auf 0,0 dB, jeder mit seiner Pegelsäule, und die Tasten REMOVE VOCAL, VOCAL ONLY und ORIGINAL.

Mach einen Gesang in einem fertigen Mix lauter oder leiser

Dazwischen gleichen die Fader einen Song neu aus, der ohne dich gemischt wurde. Die Vocal-Balance-Presets heben einen Gesang um 1,5, 3 oder 6 dB an oder senken ihn um 1,5 bis 10 dB, jedes innerhalb von 0,1 dB seines Namens gemessen (Vocal Up 6 dB ergibt +5,6 dB), die Musik innerhalb von 0,5 dB. Etwa 0,8 dB eines Gesangs werden nie getrennt, deshalb bewegt sich der Fader etwas weiter als die Stimme, und die Entfernung endet bei etwa 21 dB. Es gibt keinen Peak-Schutz: Senke OUTPUT, wenn du einen Gesang auf einem lauten Master anhebst.

  • VOCAL bis +6 dB
  • Innerhalb von 0,1 dB des Presets
  • Musik innerhalb von 0,5 dB
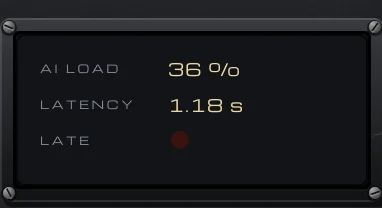
Das Statusfeld: AI LOAD 36 %, LATENCY 1,18 s und die LATE-Lampe, aus.

KI, die auf deinem Computer bleibt

Die Trennung ist Spleeter, das Open-Source-Modell von Deezer (MIT-Lizenz): zwei neuronale Netze, ausgeführt vom eigenen Code des Plugins. Kein Internet, kein Upload und kein KI-Framework zu installieren. Es läuft in Echtzeit in einem eigenen Thread, mit AVX2 auf Intel und AMD und Apples Accelerate auf dem Mac; AI LOAD zeigt, wie viel seiner Zeit es braucht, Stille kostet nichts, und alle Instanzen teilen sich eine Kopie des Modells. Die LATE-Lampe leuchtet, wenn ein ausgelasteter Computer einmal nicht hinterherkam; ein Offline-Bounce kommt immer hinterher.

  • Spleeter (MIT-Lizenz)
  • Kein Internet, kein Upload
  • Ein Modell für alle Instanzen
Das SEPARATION-Display: die letzten sechs Sekunden eines Songs von 40 Hz bis 16 kHz, die gesungene Melodie in Bernstein über der Band in Blau, mit den VOCAL-RANGE-Anfassern HI und LO am rechten Rand.

Sieh, was die KI hört

Das SEPARATION-Display zeigt die letzten sechs Sekunden des Songs von 40 Hz bis 16 kHz als Laufbild, gefärbt nach der Entscheidung des Modells: Bernstein für den Gesang, Blau für die Musik. Ein Teil, den du leiser machst, wird blasser gezeichnet, der Bereich außerhalb der VOCAL RANGE ist schattiert, und mit dem Mauszeiger liest du die Pegel von Gesang und Musik an jedem Zeitpunkt und jeder Tonhöhe ab.

  • Gesang Bernstein, Musik Blau
  • 40 Hz bis 16 kHz
  • Werte per Hover
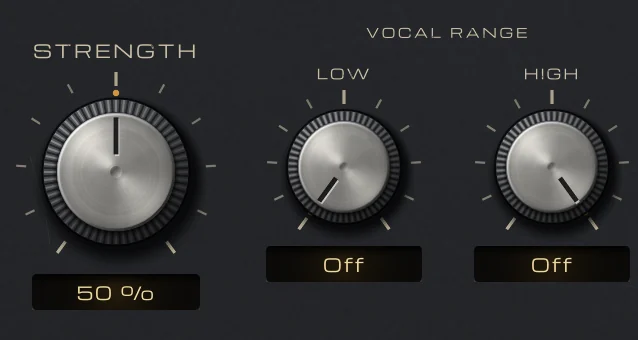
STRENGTH auf 50 % und die VOCAL-RANGE-Regler LOW und HIGH, beide aus.

Bestimme, wie entschieden es trennt

STRENGTH bestimmt, wie viel des Klangs als Stimme zählt. 50 % ist die eigene Balance des Modells und schnitt in beide Richtungen am besten ab, und 35 bis 70 % ist ein Plateau, in dem es Geschmackssache ist. Höher nimmt mehr Hall, Atmer und Doppelungen eines Gesangs mit, kostet aber die Luft der Becken (1,1 dB über 9 kHz bei 50 %, 3,5 dB bei 100 %); niedriger ist sanfter und lässt einen leisen Geist der Stimme übrig. Für ein A cappella gilt es umgekehrt: niedriger heißt weniger Übersprechen.

  • 0 bis 100 %
  • Am besten bei 50 %
  • Gemessen an bekannten Spuren
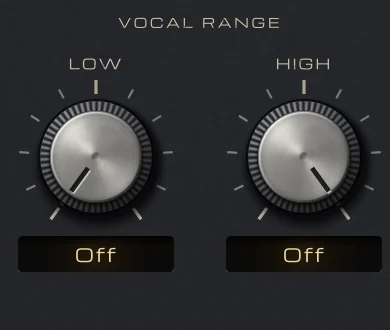
Die VOCAL-RANGE-Regler LOW und HIGH, beide aus.

Kick, Bass und Becken bleiben unberührt

Die VOCAL RANGE begrenzt, was als Stimme zählen kann: Unter LOW (bis 1 kHz) und über HIGH (bis hinunter zu 1 kHz) bleibt alles Musik, unberührt, mit einer Flanke von 48 dB pro Oktave. LOW bis etwa 90 Hz kostet eine Stimme nichts und hält Kick und Bass sauber; HIGH bei 10 bis 14 kHz bewahrt die Luft der Becken für 0,3 bis 0,6 dB mehr verbleibenden Gesang. Beide sind auch Anfasser im SEPARATION-Display.

  • 48 dB pro Oktave
  • In der Anzeige ziehen
  • Standardmäßig aus
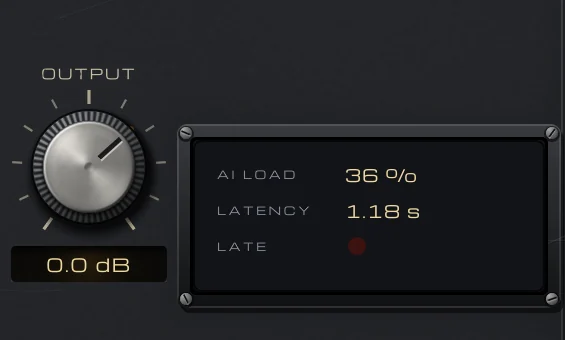
OUTPUT auf 0,0 dB neben dem Statusfeld: AI LOAD 36 %, LATENCY 1,18 s und die LATE-Lampe.

Unberührt, bis du es willst

Mit VOCAL und MUSIC beide auf 0 dB kommt der Song Bit für Bit heraus, nur verzögert, und auch der Bypass bleibt im Takt. Die KI hört etwa 1,18 s voraus, bevor sie entscheidet; deine DAW gleicht das bei der Wiedergabe und in Bounces aus, aber alles, was du live darüber abhörst, kommt verspätet an, deshalb ist es für Wiedergabe, Mischen und Bouncen gemacht. Am besten funktioniert es mit gesungenen Stimmen: Eine Sprechstimme wird nur um 5 bis 7 dB getrennt.

  • Bit für Bit bei 0 dB
  • 1,18 s, ausgeglichen
  • Am besten bei Gesang
Der Preset-Browser mit Default: Init, mit Zurück, Weiter und SAVE.

45 Presets, jedes gemessen

Acht Ordner, nach Aufgabe sortiert: Karaoke, A Cappella, Vocal Balance, Practice (Guide-Vocals und Play-Alongs für Bass, Schlagzeug und Gitarre), Remix & Sampling, Speech und Creative FX (Telefon-, gedämpfte, geflüsterte und hohle Stimmen). Jedes wurde mit dem echten Prozessor an Testsongs mit bekannten Spuren gemessen und an einem echten Master geprüft; nur die drei Vocal-Up-Presets gehen über den ursprünglichen Peak eines Masters, und ihre Notizen sagen, wie weit du OUTPUT senken solltest.

  • 8 Ordner
  • Eigene speichern
  • Mit der Session wiederhergestellt

VEIRA Vocal Remover holen

Einmal zahlen, und es gehört dir, mit allen künftigen Updates.

VEIRA Vocal Remover

Nimm den Gesang aus einem Song, behalte nur den Gesang oder mach ihn lauter oder leiser, mit KI auf deinem Computer.

  • Gehört dir: einmal zahlen, kein Abo
  • Alle künftigen Updates, kostenlos auf Lebenszeit
  • VST3, AU, Standalone auf bis zu 3 Computern
  • Meinung geändert? Storniere innerhalb von 14 Tagen (Rückerstattung)
USD

Einmalzahlung, im Warenkorb.

Willkommensangebot

10 % Rabatt auf deine erste Bestellung

Hinterlass deine E-Mail-Adresse, und wir schicken dir einen Code über 10 % Rabatt auf deine erste Bestellung, für beliebige Plugins. Ein Code pro Person.

Technische Daten

Typ
Vocal-Remover: KI-Trennung eines gemischten Songs in Gesang und Musik, wieder gemischt auf deine Pegel
Modell
Spleeter 2-Stem von Deezer Research (MIT-Lizenz), auf deinem Computer vom eigenen Code des Plugins ausgeführt; kein Internet, kein Upload
Pegel
VOCAL- und MUSIC-Fader, Off bis +6 dB (0 dB bei drei Vierteln des Wegs); REMOVE VOCAL, VOCAL ONLY und ORIGINAL
Strength
0 bis 100 % (Standard 50 %, die eigene Balance des Modells)
Stimmbereich
LOW 20 Hz (aus) bis 1 kHz, HIGH 1 kHz bis 20 kHz (aus); 48 dB/Oktave jenseits beider
Output
−24 bis +12 dB
Gemessen
An Testsongs bei STRENGTH 50 %: ein gesungener Gesang auf etwa −21 dB entfernt, das Übersprechen der Band in einem A cappella bei etwa −23 dB; eine Sprechstimme wird nur um 5 bis 7 dB getrennt
Latenz
52.224 Samples bei 44,1 kHz, 56.925 bei 48 kHz (etwa 1,18 s), an deine DAW gemeldet; mit beiden Fadern auf 0 dB und im Bypass das Eingangssignal um die Latenz verzögert, Bit für Bit
Metering
SEPARATION-Display (laufendes Spektrogramm, 40 Hz bis 16 kHz, Gesang und Musik eingefärbt); eine Pegelsäule pro Fader; AI LOAD, LATENCY und LATE; IN und OUT als Peak und RMS; Short-Term- und integrierte LUFS
Presets
45 Werkspresets in 8 Ordnern (darunter Karaoke, A Cappella, Practice und Speech), plus deine eigenen
Kanäle
Mono oder Stereo
CPU (gemessen)
KI-Last etwa 35 bis 45 % eines Kerns einer Cloud-VM mit 2 Kernen; viel weniger auf Apple Silicon; nichts bei Stille. Etwa 80 MB Speicher für das Modell, geteilt von allen Instanzen
Formate
VST3, AU, Standalone
macOS
macOS 11 oder neuer, Apple silicon oder Intel (Universal). VST3, AU und Standalone.
Windows
Windows 10 oder neuer, 64 Bit. VST3 und Standalone.
Pro Tools
Pro-Tools-Versionen (AAX) sind gebaut und getestet und erscheinen, sobald sie für Pro Tools signiert sind.
Neueste Version
0.2.1, erschienen am 31. Oktober 2026 · Was ist neu
Mehr dazu im Blog: A cappella oder Instrumental aus einem fertigen Song holen

Fragen? 9 Antworten zu VEIRA Vocal Remover

Passt gut zu

VEIRA EQ

Ein dynamischer Equalizer mit bis zu 24 Bändern und einem Analyzer, den du lesen kannst.

$149.99

VEIRA DeEss

Ein De-Esser, der dir jedes „s“ zeigt.

$149.99

VEIRA Max

Ein lauter, sauberer Mastering-Limiter, der jedes Dezibel zeigt, das er wegnimmt.

$149.99