A cappella oder Instrumental aus einem fertigen Song holen
Wie Gesangstrennung funktioniert, was sie kann und was nicht, welche Einstellungen für ein Instrumental, eine A cappella oder eine neue Gesangsbalance zählen und wie du das Ergebnis prüfst.
Manchmal hast du nur den fertigen Stereomix. Ein Remix braucht den Gesang allein, eine Sängerin will über die Band proben, ein Karaoke-Abend braucht das Instrumental, und die Mehrspuren sind längst weg oder gehörten nie dir. Trenn-Tools sind darin sehr gut geworden, aber was sie dir liefern, bleibt eine Schätzung, und zu wissen, wo sie sich schwertun, macht aus einem groben Ergebnis ein brauchbares.
Warum der alte Phasentrick nicht reicht
Der klassische Trick: Du drehst die Polarität einer Seite und addierst sie zur anderen, was alles auslöscht, was genau in der Mitte liegt. Der Leadgesang tut das meist, aber auch Kick, Snare und Bass, und der Stereohall und die Doppelungen der Stimme überleben unberührt. Übrig bleibt eine dünne Monospur mit einem Geist der Stimme darin, und eine A cappella kann der Trick überhaupt nicht liefern.
Was ein Trennmodell wirklich tut
Ein Trennmodell hat gelernt, wie eine Stimme im Spektrum aussieht. Moment für Moment und Frequenz für Frequenz entscheidet es, wie viel des Klangs Stimme ist und wie viel alles andere, und baut aus diesen Entscheidungen zwei Signale neu auf. Weil es Entscheidungen sind, gibt es immer einen Kompromiss: Treibst du das Modell an, mehr zu nehmen, nimmt es Becken, Synths und andere helle Klänge mit der Stimme mit; bremst du es, bleibt ein leiser Geist des Gesangs in der Musik.
Richte deine Erwartungen nach der Aufgabe
Jede Aufgabe verzeiht andere Fehler, also entscheide, was du brauchst, bevor du einem perfekten Ergebnis hinterherjagst.
- Karaoke und Übungstracks: Ein Gesang, der etwa 20 dB leiser ist, ist für die meisten Hörer weg, sobald die Band spielt, und kleine Artefakte verstecken sich unter dem, der mitsingt.
- Remixe und Samples: Eine A cappella trägt etwas von der Band mit, oft Hi-Hats und Hall. Unter neuen Drums ist das meist in Ordnung; frei in einem ruhigen Intro nicht.
- Neu ausbalancieren: Einen Gesang ein paar dB lauter oder leiser zu machen, ist die nachsichtigste Aufgabe von allen, weil beide Teile noch da sind, nur in anderer Balance.
- Sprache, Chöre und stark bearbeitete Stimmen trennen sich weniger sauber als ein einzelner gesungener Lead, also plane mehr Aufräumarbeit ein.
Räum auf, was die Trennung übrig lässt
Behandle die getrennten Teile wie jede andere Aufnahme. Ein Leadgesang hat unter etwa 80–100 Hz kaum nutzbare Energie, also lass diesen Bereich in der Musik: Das schützt Kick und Bass davor, in die Stimme gezogen zu werden. Rechne damit, dass ein getrennter Gesang allein etwas rau klingt; ein sanfter EQ und etwas Schnitt oder ein Gate zwischen den Phrasen helfen viel. Prüf auf Kopfhörern, die Reste zeigen, die Lautsprecher verbergen, und denk daran, dass der Song weiterhin seinen Eigentümern gehört: Zu Hause üben ist eine Sache, eine Veröffentlichung braucht eine Erlaubnis.
So geht es mit VEIRA Vocal Remover
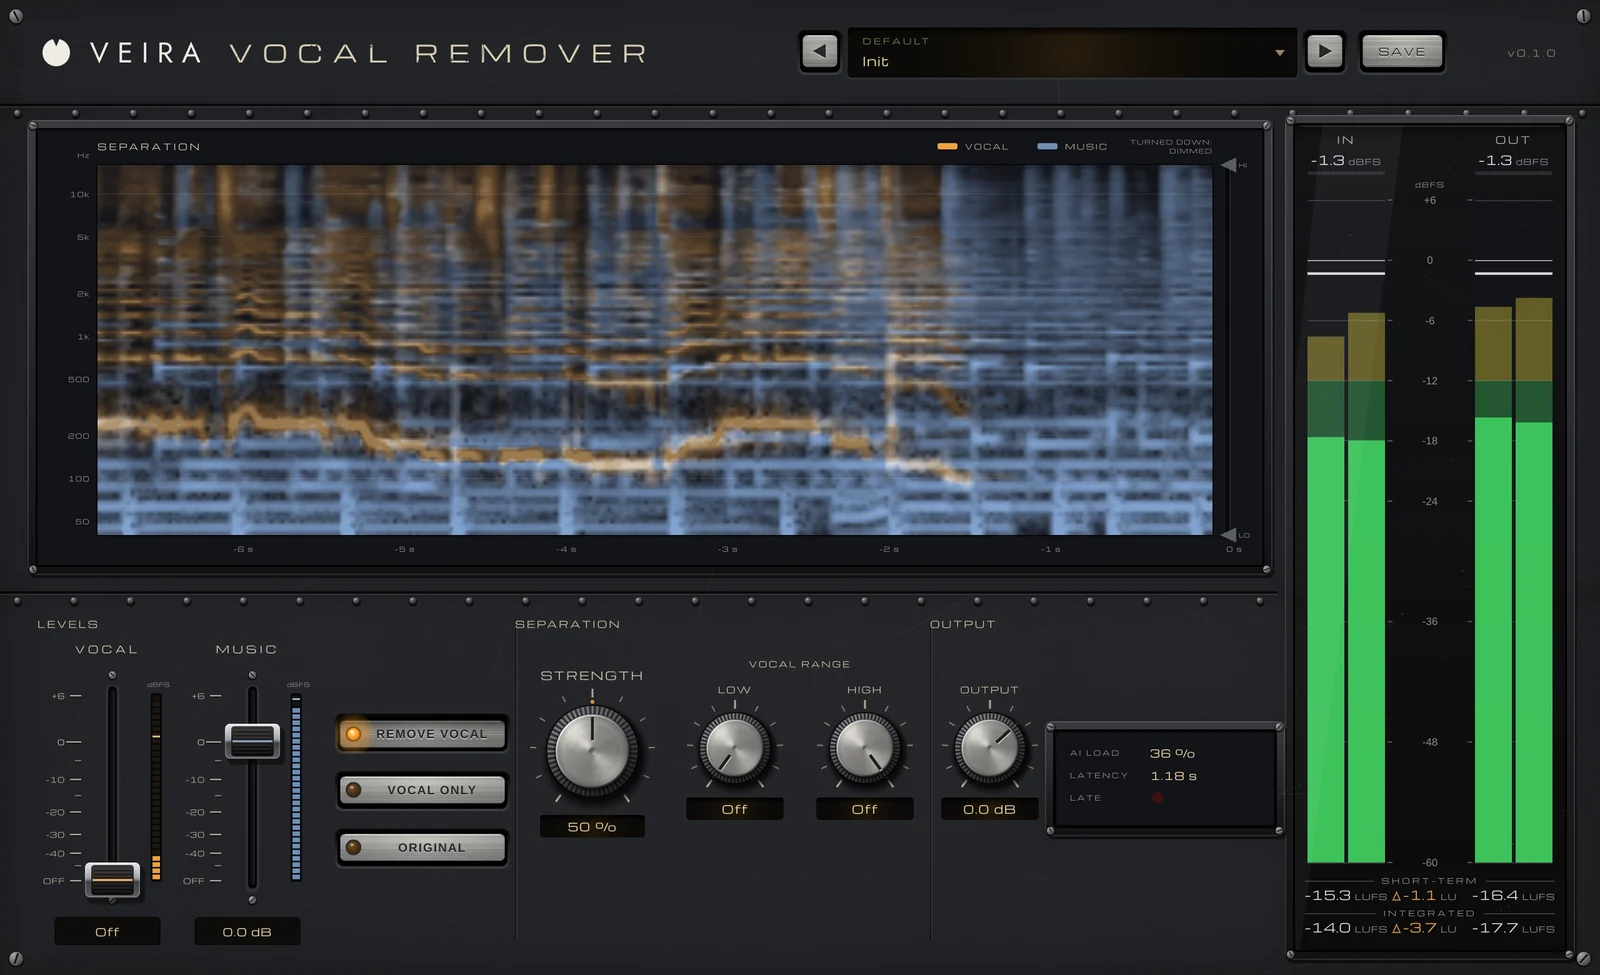
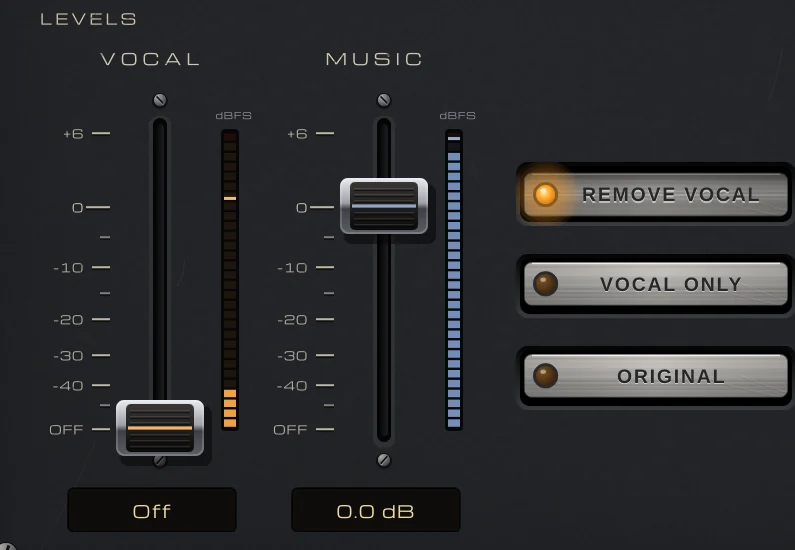
VEIRA Vocal Remover teilt einen fertigen Stereosong in seinen Gesang und alles andere, mit einem KI-Trennmodell, das im Plugin auf deinem Computer läuft, ohne Internet und ohne Upload. Zwei Pultfader, VOCAL und MUSIC, bestimmen, wie laut jeder Teil zurückkommt, von Off bis +6 dB, und REMOVE VOCAL, VOCAL ONLY und ORIGINAL stellen beide mit einem Klick ein. Gemessen an Testsongs mit bekannten Einzelteilen lassen seine Karaoke-Presets den Gesang 19 bis 23 dB leiser, die Musik bleibt innerhalb von 0,6 dB.
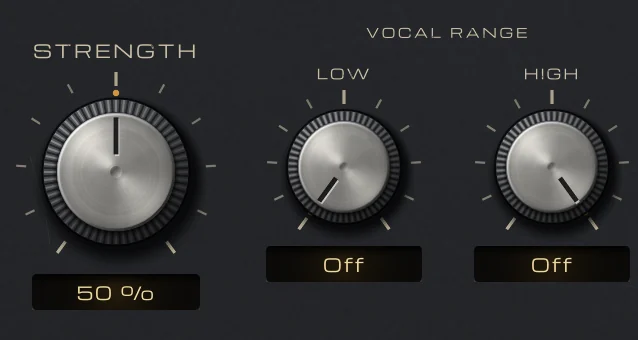
STRENGTH bestimmt, wie entschieden das Modell festlegt, was Stimme ist. 50 % hat in beide Richtungen am besten gemessen, und 35 bis 70 % ist Geschmackssache: Höher nimmt mehr von Hall, Atmern und Doppelungen der Stimme, nimmt aber die Luft der Becken mit, und für eine A cappella heißt niedriger weniger Übersprechen. Die VOCAL RANGE hält Kick, Bass und Becken heraus: LOW bis etwa 90 Hz nimmt einer Stimme nichts, und HIGH bei 10 bis 14 kHz erhält die Luft der Becken.
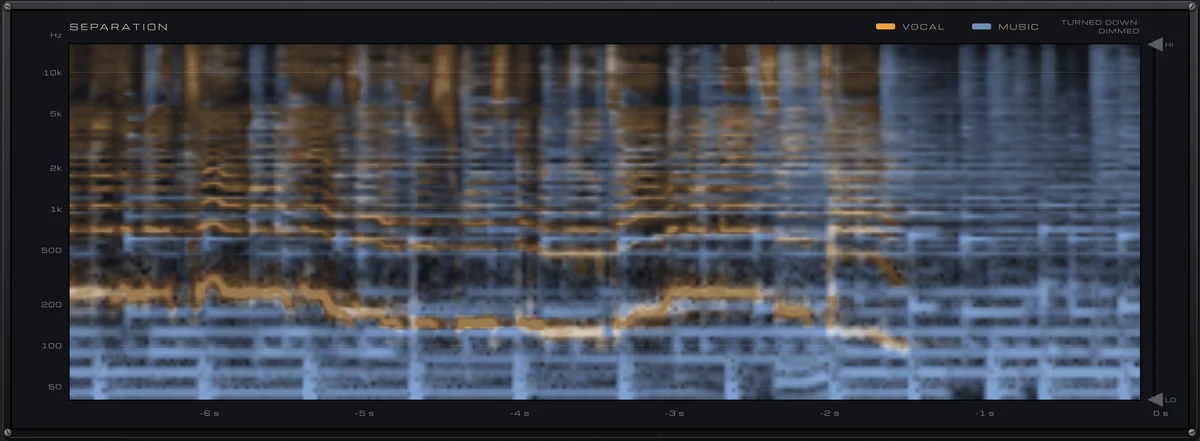
Die SEPARATION-Anzeige zeigt den Gesang in Bernstein und die Musik in Blau, damit du siehst, was die KI hört. Das Plugin hört etwa 1,18 s voraus, was deine DAW bei der Wiedergabe und beim Bouncen ausgleicht, also ist es für Wiedergabe, Mischen und Bouncen gemacht, nicht fürs Live-Abhören. Es gibt keinen Spitzenschutz: Nimm OUTPUT zurück, wenn du einen Gesang auf einem lauten Master lauter machst.