VEIRA Vocal Remover

Quita la voz de una canción, deja solo la voz o súbela o bájala, con IA en tu computadora.

$29.99, un pago único con actualizaciones gratis

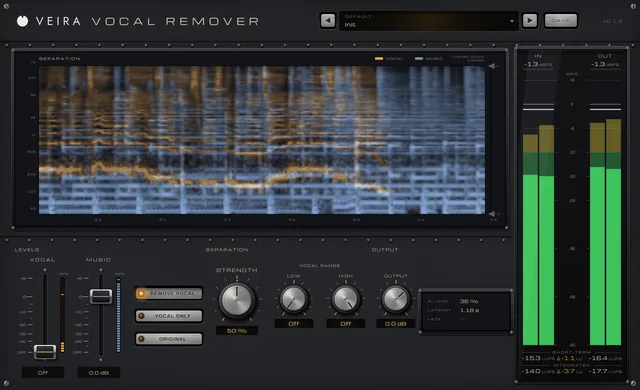
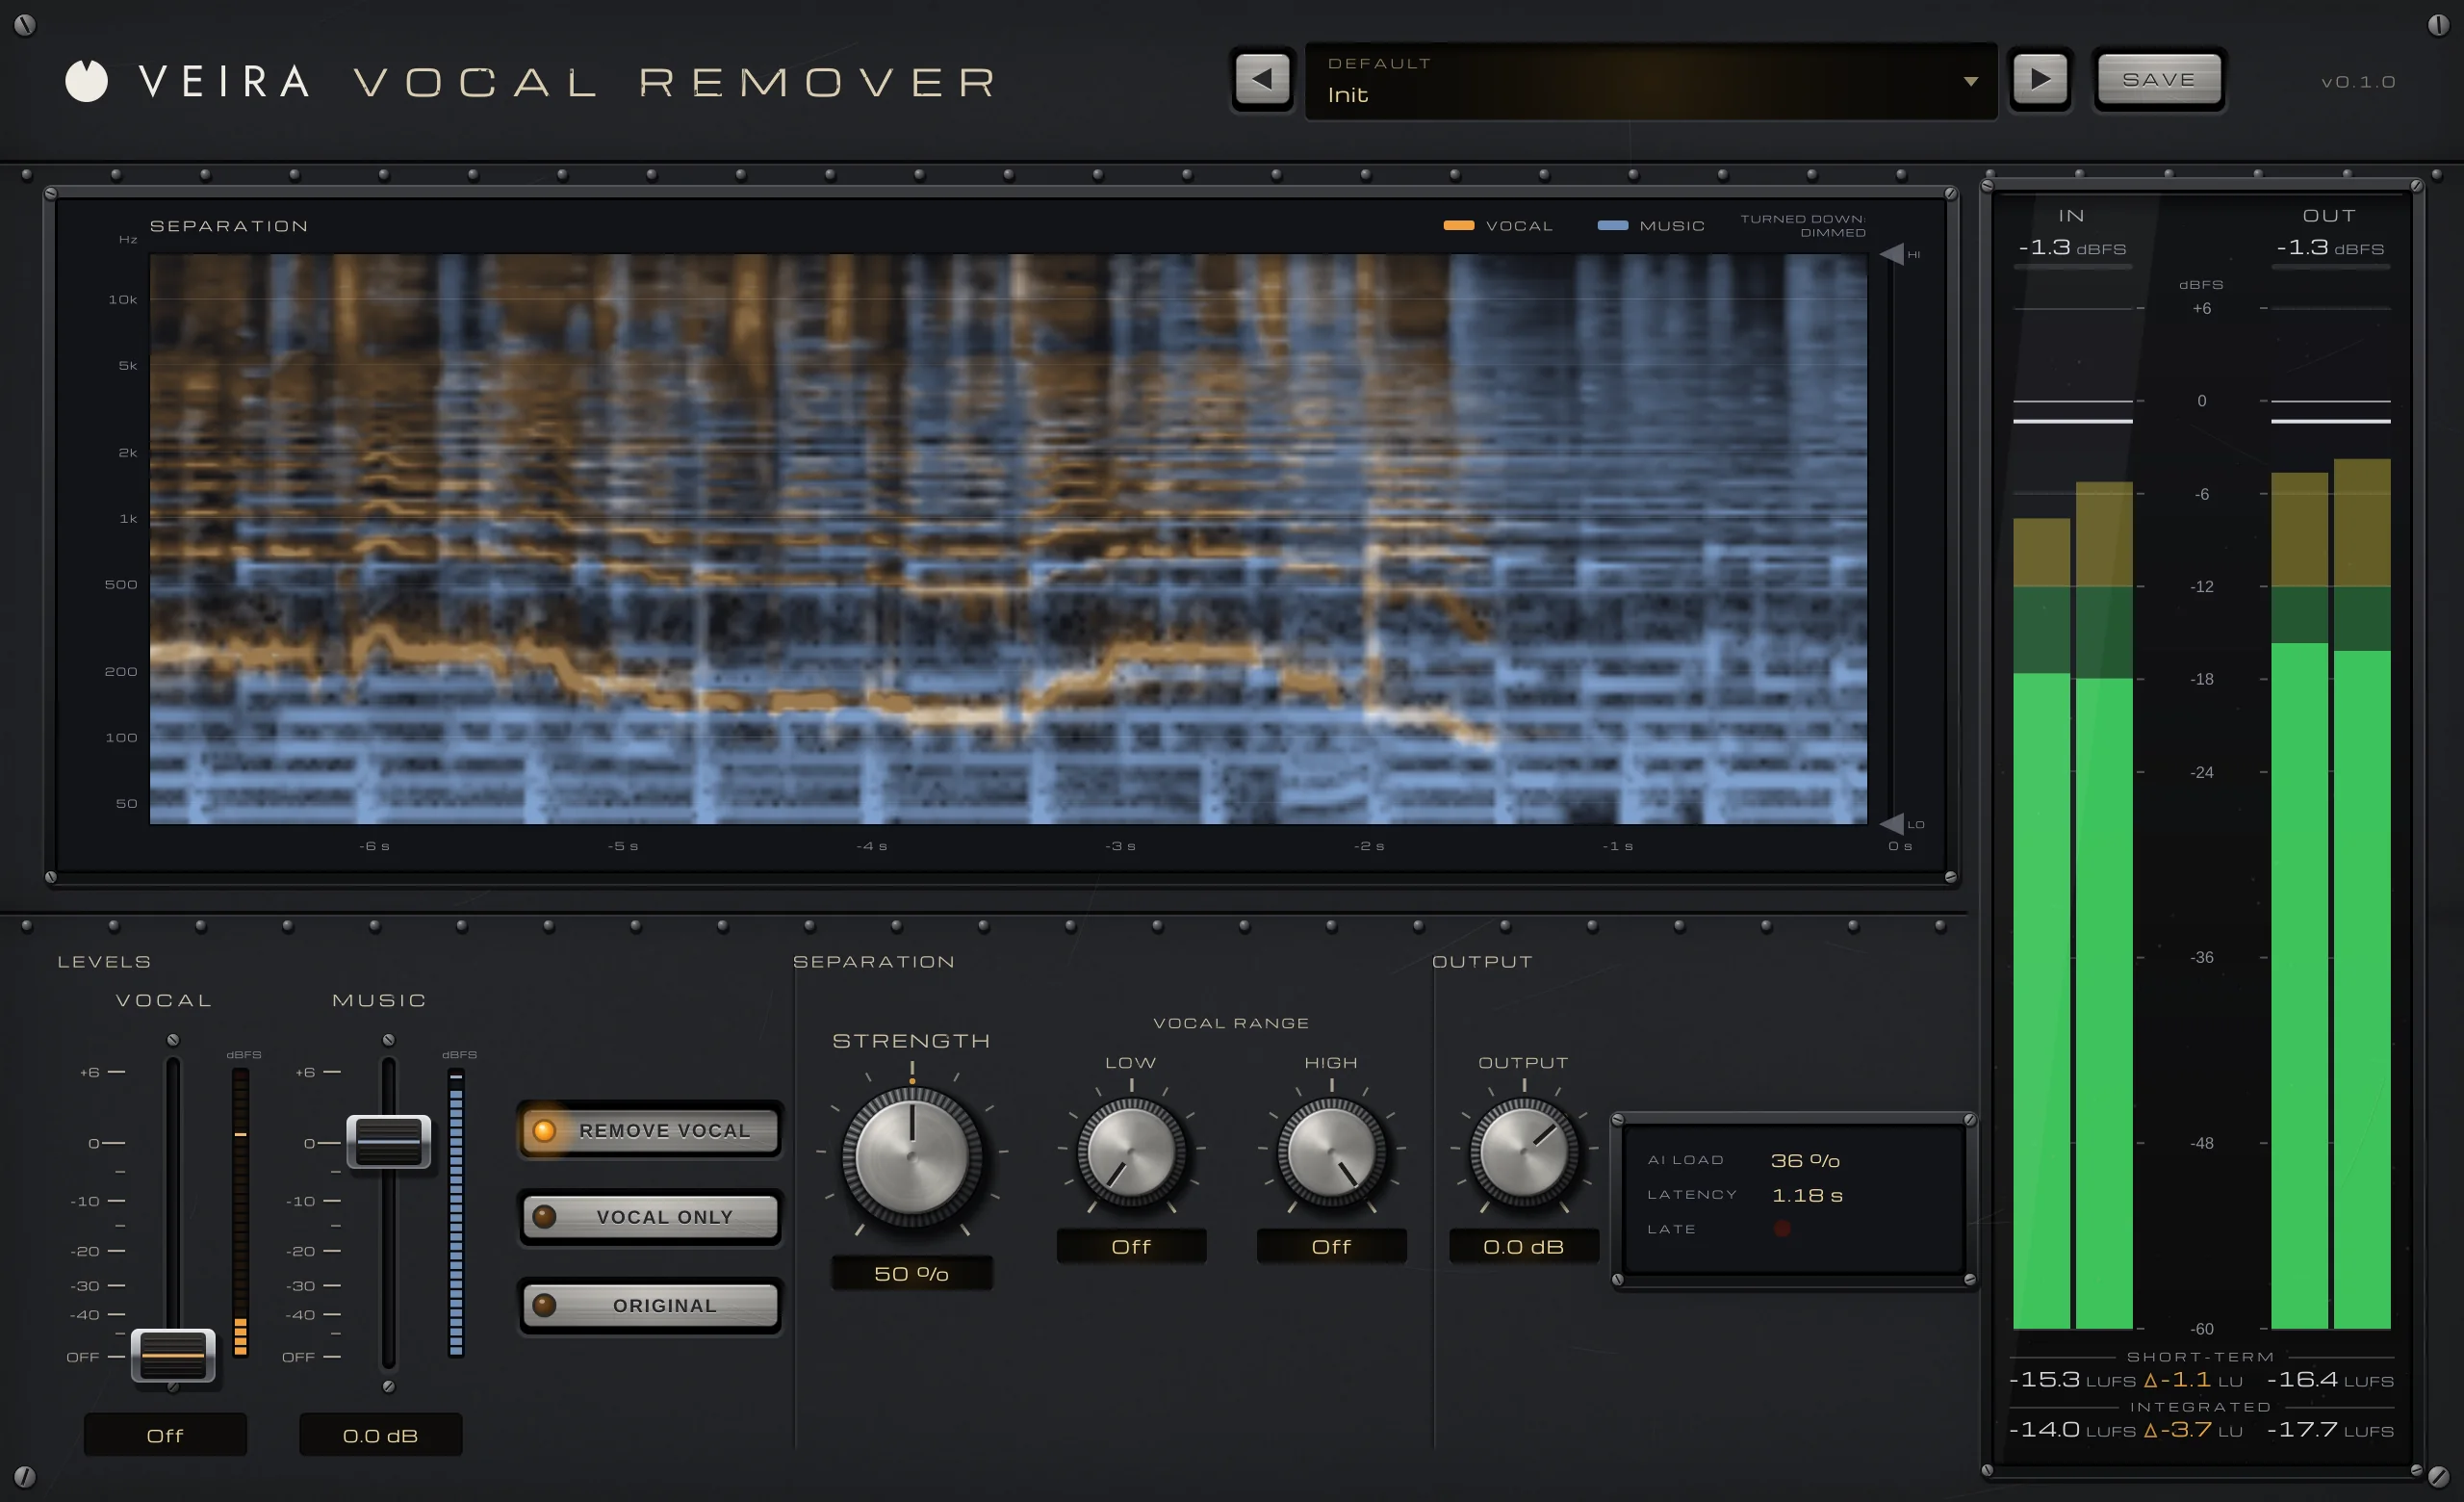
VEIRA Vocal Remover con el preset Init mientras suena una canción: la pantalla SEPARATION con la voz en ámbar sobre la música en azul, los faders VOCAL y MUSIC con REMOVE VOCAL encendido, STRENGTH y las perillas de VOCAL RANGE, OUTPUT con AI LOAD y LATENCY, y los medidores IN y OUT con sonoridad.

VEIRA Vocal Remover quita la voz de una canción terminada, deja solo la voz o la sube o la baja dentro de la mezcla. Un modelo de IA escucha la canción y la separa en voz y música, y dos faders de consola, VOCAL y MUSIC, fijan qué tan fuerte vuelve cada parte: una pista de karaoke o un instrumental con un clic, un a cappella con otro, o una voz unos dB más fuerte o más suave en una canción que no puedes abrir.

Lo que lo distingue es que funciona en tu propia computadora, en cualquier DAW, sin subir nada y sin internet. El modelo es Spleeter, del equipo de investigación de Deezer, ejecutado en tiempo real por el propio código del plugin. Con ambos faders en 0 dB la canción pasa bit a bit, STRENGTH y el VOCAL RANGE guían lo que la IA puede llevarse, y la pantalla SEPARATION muestra lo que oye. Escucha unos 1.18 segundos por adelantado, lo que tu DAW compensa en la reproducción, y funciona mejor con voces cantadas.

Un recorrido por VEIRA Vocal Remover

VEIRA Vocal Remover con el preset Init mientras suena una canción: la pantalla SEPARATION con la voz en ámbar sobre la música en azul, los faders VOCAL y MUSIC con REMOVE VOCAL encendido, STRENGTH y las perillas de VOCAL RANGE, OUTPUT con AI LOAD y LATENCY, y los medidores IN y OUT con sonoridad.
  1. VEIRA Vocal Remover completo

    VEIRA Vocal Remover separa una canción estéreo terminada en su voz y todo lo demás, con un modelo de separación por IA que funciona dentro del plugin, en tu computadora. Dos faders de consola, VOCAL y MUSIC, fijan qué tan fuerte vuelve cada parte: VOCAL apagado para una pista de karaoke o un instrumental, MUSIC apagado para un a cappella, y cualquier punto intermedio para subir o bajar una voz. STRENGTH fija con qué firmeza el modelo decide qué es voz, el VOCAL RANGE deja el bombo, el bajo y los platillos fuera de ella, y la pantalla SEPARATION muestra la voz en ámbar y la música en azul.

  2. Lo que oye la IA

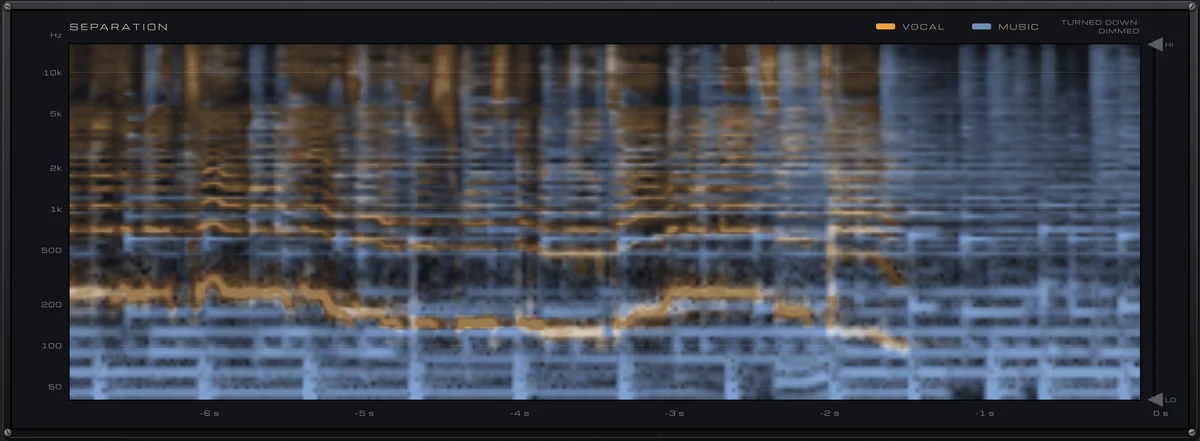
    Los últimos seis segundos de la canción por altura: la voz en ámbar, la música en azul y, más tenue, la parte que bajas.

  3. Voz y música

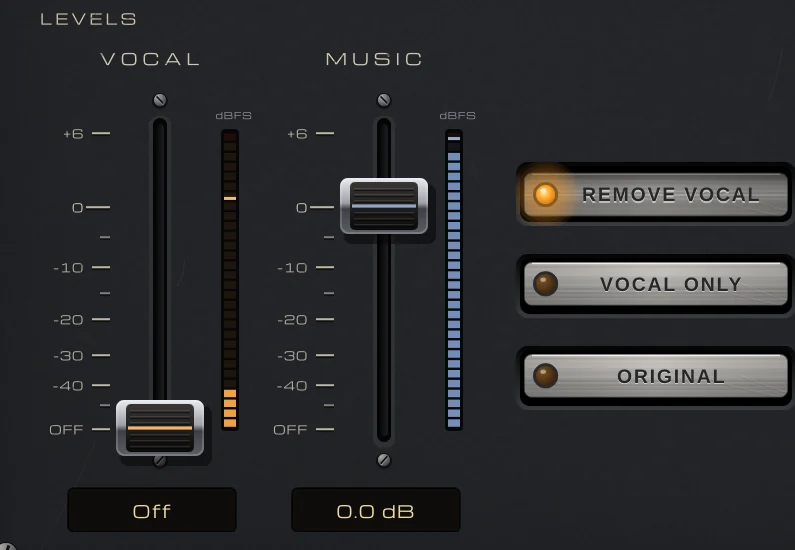
    Dos faders, de Off a +6 dB, con una columna de nivel cada uno; un clic para REMOVE VOCAL, VOCAL ONLY u ORIGINAL.

  4. Separación

    STRENGTH fija con qué firmeza la IA decide qué es voz; el VOCAL RANGE deja los graves y los agudos fuera de ella.

  5. Salida y estado

    OUTPUT, cuánto trabaja la IA, la latencia que compensa tu DAW y la lámpara LATE.

  6. Entrada y salida

    Pico y RMS de la entrada y la salida, con sonoridad de corto plazo e integrada.

Lo que VEIRA Vocal Remover hace por ti

Los botones REMOVE VOCAL, VOCAL ONLY y ORIGINAL, con REMOVE VOCAL encendido.

Quita la voz o deja solo la voz

Dos faders de consola fijan las dos partes: VOCAL para la voz que encuentra la IA y MUSIC para todo lo demás, cada uno de Off a +6 dB. REMOVE VOCAL, VOCAL ONLY y ORIGINAL fijan ambos con un clic, para una pista de karaoke, un instrumental o un a cappella. Medidos en canciones de prueba cuyas partes se conocen, los presets de Karaoke dejan la voz entre 19 y 23 dB más abajo con la música a menos de 0.6 dB, y los presets de A Cappella dejan la fuga de la banda entre 20 y 27 dB más abajo.

  • Voz entre 19 y 23 dB más abajo
  • Música a menos de 0.6 dB
  • Ajustes con un clic
LEVELS: el fader VOCAL en Off y el fader MUSIC en 0.0 dB, cada uno con su columna de nivel, y los botones REMOVE VOCAL, VOCAL ONLY y ORIGINAL.

Sube o baja una voz en una mezcla terminada

Entre ambos extremos, los faders reequilibran una canción que se mezcló sin ti. Los presets de Vocal Balance suben una voz 1.5, 3 o 6 dB o la bajan de 1.5 a 10 dB, cada uno medido a menos de 0.1 dB de su nombre (Vocal Up 6 dB da +5.6 dB) con la música a menos de 0.5 dB. Alrededor de 0.8 dB de una voz nunca se separa, así que el fader se mueve un poco más que la voz y la eliminación llega a un mínimo de unos 21 dB. No hay protección de picos: baja OUTPUT cuando subas una voz en un máster fuerte.

  • VOCAL hasta +6 dB
  • A menos de 0.1 dB del preset
  • Música a menos de 0.5 dB
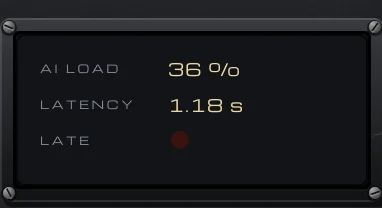
El panel de estado: AI LOAD 36 %, LATENCY 1.18 s y la lámpara LATE, apagada.

IA que se queda en tu computadora

La separación es Spleeter, el modelo de código abierto de Deezer (licencia MIT): dos redes neuronales que ejecuta el propio código del plugin. No hay internet, no se sube nada y no hay que instalar ningún framework de IA. Funciona en tiempo real en un hilo aparte, con AVX2 en Intel y AMD y Accelerate de Apple en los Mac; AI LOAD muestra cuánto de su tiempo usa, el silencio no cuesta nada y todas las instancias comparten una sola copia del modelo. La lámpara LATE se enciende si una computadora ocupada se quedó atrás alguna vez; un bounce offline nunca se queda atrás.

  • Spleeter (licencia MIT)
  • Sin internet, sin subir nada
  • Un modelo para todas las instancias
La pantalla SEPARATION: los últimos seis segundos de una canción de 40 Hz a 16 kHz, la melodía cantada en ámbar sobre la banda en azul, con los tiradores HI y LO del VOCAL RANGE en el borde derecho.

Mira lo que oye la IA

La pantalla SEPARATION desplaza los últimos seis segundos de la canción de 40 Hz a 16 kHz, coloreados según lo que decide el modelo: ámbar para la voz, azul para la música. Una parte que bajas se dibuja más tenue, la zona fuera del VOCAL RANGE aparece sombreada y, al pasar el cursor, lees los niveles de voz y de música en cualquier momento y altura.

  • Voz en ámbar, música en azul
  • 40 Hz a 16 kHz
  • Lectura al pasar el cursor
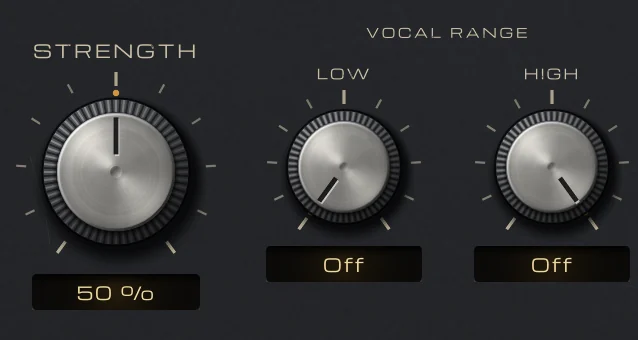
STRENGTH al 50 % y las perillas LOW y HIGH del VOCAL RANGE, ambas apagadas.

Decide con qué firmeza separa

STRENGTH fija cuánto del sonido cuenta como voz. 50 % es el equilibrio propio del modelo y midió lo mejor en ambos sentidos, y de 35 a 70 % hay una meseta donde es cuestión de gusto. Más alto se lleva más reverb, respiraciones y dobles de una voz, pero le cuesta el aire a los platillos (1.1 dB por encima de 9 kHz al 50 %, 3.5 dB al 100 %); más bajo es más suave y deja un leve fantasma de la voz. Para un a cappella funciona al revés: más bajo significa menos fuga.

  • 0 a 100 %
  • Lo mejor al 50 %
  • Medido con partes conocidas
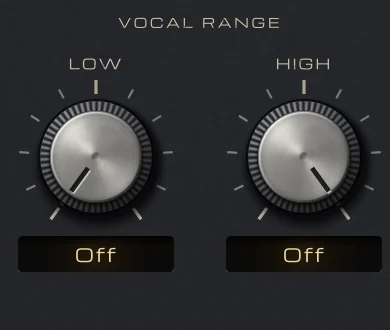
Las perillas LOW y HIGH del VOCAL RANGE, ambas apagadas.

El bombo, el bajo y los platillos, intactos

El VOCAL RANGE limita lo que puede contar como voz: por debajo de LOW (hasta 1 kHz) y por encima de HIGH (hasta 1 kHz hacia abajo) todo sigue siendo música, intacto, con una pendiente de 48 dB por octava. LOW hasta unos 90 Hz no le cuesta nada a la voz y deja limpios el bombo y el bajo; HIGH entre 10 y 14 kHz conserva el aire de los platillos a cambio de 0.3 a 0.6 dB más de voz restante. Ambos son también tiradores en la pantalla SEPARATION.

  • 48 dB por octava
  • Arrastra en la pantalla
  • Apagado por defecto
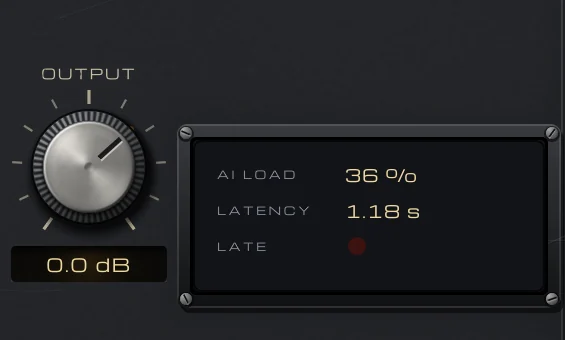
OUTPUT en 0.0 dB junto al panel de estado: AI LOAD 36 %, LATENCY 1.18 s y la lámpara LATE.

Intacto hasta que lo pides

Con VOCAL y MUSIC ambos en 0 dB, la canción sale bit a bit, solo retrasada, y el bypass también se mantiene a tiempo. La IA escucha unos 1.18 s por adelantado antes de decidir; tu DAW lo compensa en la reproducción y en los bounces, pero todo lo que monitoreas en vivo a través de él llega tarde, así que está hecho para reproducir, mezclar y hacer bounces. Funciona mejor con voces cantadas: una voz hablada se separa solo de 5 a 7 dB.

  • Bit a bit en 0 dB
  • 1.18 s, compensados
  • Lo mejor con canto
El navegador de presets mostrando Default: Init, con anterior, siguiente y SAVE.

45 presets, cada uno medido

Ocho carpetas ordenadas por tarea: Karaoke, A Cappella, Vocal Balance, Practice (voces guía y pistas para tocar encima con bajo, batería y guitarra), Remix & Sampling, Speech y Creative FX (voces de teléfono, apagadas, susurradas y huecas). Cada uno se midió con el procesador real en canciones de prueba cuyas partes se conocen y se comprobó en un máster real; solo los tres presets Vocal Up pasan el pico original de un máster, y sus notas dicen cuánto bajar OUTPUT.

  • 8 carpetas
  • Guarda los tuyos
  • Se recuperan con tu sesión

Obtén VEIRA Vocal Remover

Paga una vez y es tuyo, con todas las actualizaciones futuras incluidas.

VEIRA Vocal Remover

Quita la voz de una canción, deja solo la voz o súbela o bájala, con IA en tu computadora.

  • Tuyo para siempre: pagas una vez, sin suscripción
  • Todas las actualizaciones futuras, gratis de por vida
  • VST3, AU, Standalone en hasta 3 computadoras
  • ¿Cambiaste de opinión? Cancela dentro de 14 días (reembolsos)
USD

Pago único, en tu carrito.

Oferta de bienvenida

10% de descuento en tu primer pedido

Déjanos tu email y te enviamos un código con un 10% de descuento en tu primer pedido, en cualquier plugin. Un código por persona.

Especificaciones

Tipo
Eliminador de voces: separación por IA de una canción mezclada en voz y música, vueltas a mezclar a tus niveles
Modelo
Spleeter 2-stem de Deezer Research (licencia MIT), ejecutado en tu computadora por el propio código del plugin; sin internet, sin subir nada
Niveles
Faders VOCAL y MUSIC, de Off a +6 dB (0 dB a tres cuartos del recorrido); REMOVE VOCAL, VOCAL ONLY y ORIGINAL
Strength
0 a 100 % (por defecto 50 %, el equilibrio propio del modelo)
Rango vocal
LOW de 20 Hz (apagado) a 1 kHz, HIGH de 1 kHz a 20 kHz (apagado); 48 dB/octava más allá de cada uno
Salida
−24 a +12 dB
Medido
En canciones de prueba con STRENGTH al 50 %: una voz cantada eliminada hasta unos −21 dB, la fuga de la banda en un a cappella de unos −23 dB; una voz hablada se separa solo de 5 a 7 dB
Latencia
52,224 muestras a 44.1 kHz, 56,925 a 48 kHz (unos 1.18 s), informada a tu DAW; con ambos faders en 0 dB y en bypass, la entrada retrasada por la latencia, bit a bit
Medición
Pantalla SEPARATION (espectrograma que se desplaza, de 40 Hz a 16 kHz, con la voz y la música coloreadas); una columna de nivel por fader; AI LOAD, LATENCY y LATE; pico y RMS de IN y OUT; LUFS a corto plazo e integrados
Presets
45 presets de fábrica en 8 carpetas (incluidas Karaoke, A Cappella, Practice y Speech), más los tuyos
Canales
Mono o estéreo
CPU (medido)
Carga de la IA de alrededor de 35 a 45 % de un núcleo de una VM en la nube de 2 núcleos; mucho menos en Apple silicon; nada en silencio. Unos 80 MB de memoria para el modelo, compartidos por todas las instancias
Formatos
VST3, AU, Standalone
macOS
macOS 11 o posterior, Apple silicon o Intel (universal). VST3, AU y Standalone.
Windows
Windows 10 o posterior, 64 bits. VST3 y Standalone.
Pro Tools
Las versiones de Pro Tools (AAX) ya están compiladas y probadas, y llegarán en cuanto estén firmadas para Pro Tools.
Última versión
0.2.1, publicada el 31 de octubre de 2026 · Novedades
Lee más en el blog: Cómo sacar una a cappella o una instrumental de una canción terminada

¿Preguntas? 9 respuestas sobre VEIRA Vocal Remover

Combina bien con

VEIRA EQ

Un ecualizador dinámico con hasta 24 bandas y un analizador que puedes leer.

$149.99

VEIRA DeEss

Un de-esser que te muestra cada “s”.

$149.99

VEIRA Max

Un limitador de mastering fuerte y limpio que muestra cada decibel que quita.

$149.99