Cómo armar una cadena de voz: qué va primero, qué va al final y por qué
Qué procesadores suele necesitar una voz principal, el orden que funciona para la mayoría de las voces, por qué cada uno va donde va y cuándo tiene sentido romper la regla.
Una voz principal rara vez se arregla con un solo procesador. La mayoría pasa por una cadena corta: algo para limpiarla, algo para darle forma al tono, algo para emparejar el nivel, algo para domar las “s” y algo de espacio alrededor. Cada procesador escucha lo que hizo el anterior, así que el orden cambia el resultado tanto como los ajustes. Si lo haces bien, cada etapa tiene un trabajo más fácil; si lo haces mal, terminas peleando contra tu propia cadena.
Primero, limpia
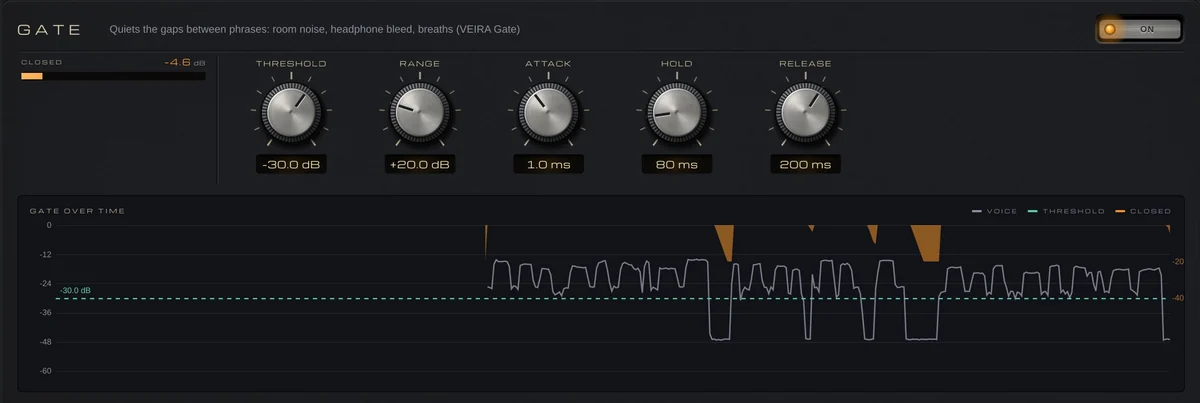
Empieza por quitar lo que no es la voz. Un filtro pasa altos elimina el retumbe, los golpes al pedestal y los popeos; un punto de partida habitual para la mayoría de las voces está entre 80 y 100 Hz, más abajo para un cantante grave. Después, una compuerta o un expansor suave puede bajar la fuga de los audífonos, el ruido del cuarto y las respiraciones fuertes entre frases. Haz esto antes de cualquier cosa que agregue ganancia: un compresor sube las partes suaves de una pista, y el ruido sube con ellas.
Afina y da forma antes de comprimir
La corrección de afinación funciona mejor sobre una voz limpia y seca, así que suele ir temprano, antes de cualquier cosa que agregue armónicos, ecos o reverb. Después viene la EQ: cortar el lodo de medios graves o una resonancia acajonada antes del compresor hace que el compresor ya no reaccione a eso, y trabaje sobre las palabras y no sobre el cuarto. Hay quien lo divide: cortes correctivos antes del compresor, presencia y aire después.
Luego el compresor empareja la interpretación, para que las palabras suaves no desaparezcan y las fuertes no salten; unos pocos decibelios de reducción de ganancia en las frases más fuertes son un punto de partida habitual.
El de-esser va después del compresor
La compresión con ganancia de compensación sube todo lo que no reduce, incluida la sibilancia, y un realce de presencia o de aire la vuelve todavía más filosa. Por eso el de-esser suele ir después de ambos: atrapa las “s” al nivel en que realmente se van a escuchar. Si la sibilancia es extrema, un de-esser ligero antes del compresor evita que también dispare la compresión. Una cadena típica:
- Limpieza: un filtro pasa altos y cualquier reducción de ruido.
- Compuerta o expansor, para bajar los huecos entre frases.
- Corrección de afinación, mientras la voz sigue seca y limpia.
- EQ: quita el lodo y el sonido acajonado, y luego agrega presencia o aire al gusto.
- Compresión, para emparejar las palabras.
- De-esser, para atrapar la sibilancia que subieron el compresor y la EQ.
- Saturación, para color y densidad.
- Delay y reverb, al final de la cadena o en envíos.
El color y el espacio van al final
La saturación después de la dinámica agrega densidad y armónicos a un nivel que ya es parejo, así que el efecto se mantiene igual de palabra en palabra. El delay y la reverb van al final de todo, o en envíos, para que sus colas no las apriete el compresor ni las abrillante la EQ.
Sabe cuándo romper la regla
El orden de arriba es un punto de partida, no una ley. La EQ después del compresor mantiene tus realces exactamente como los ajustaste; la saturación antes da un sonido más sucio. Intercambia dos procesadores y compara al mismo nivel, porque lo más fuerte casi siempre suena mejor al principio.
Hacerlo con VEIRA Vocal Strip
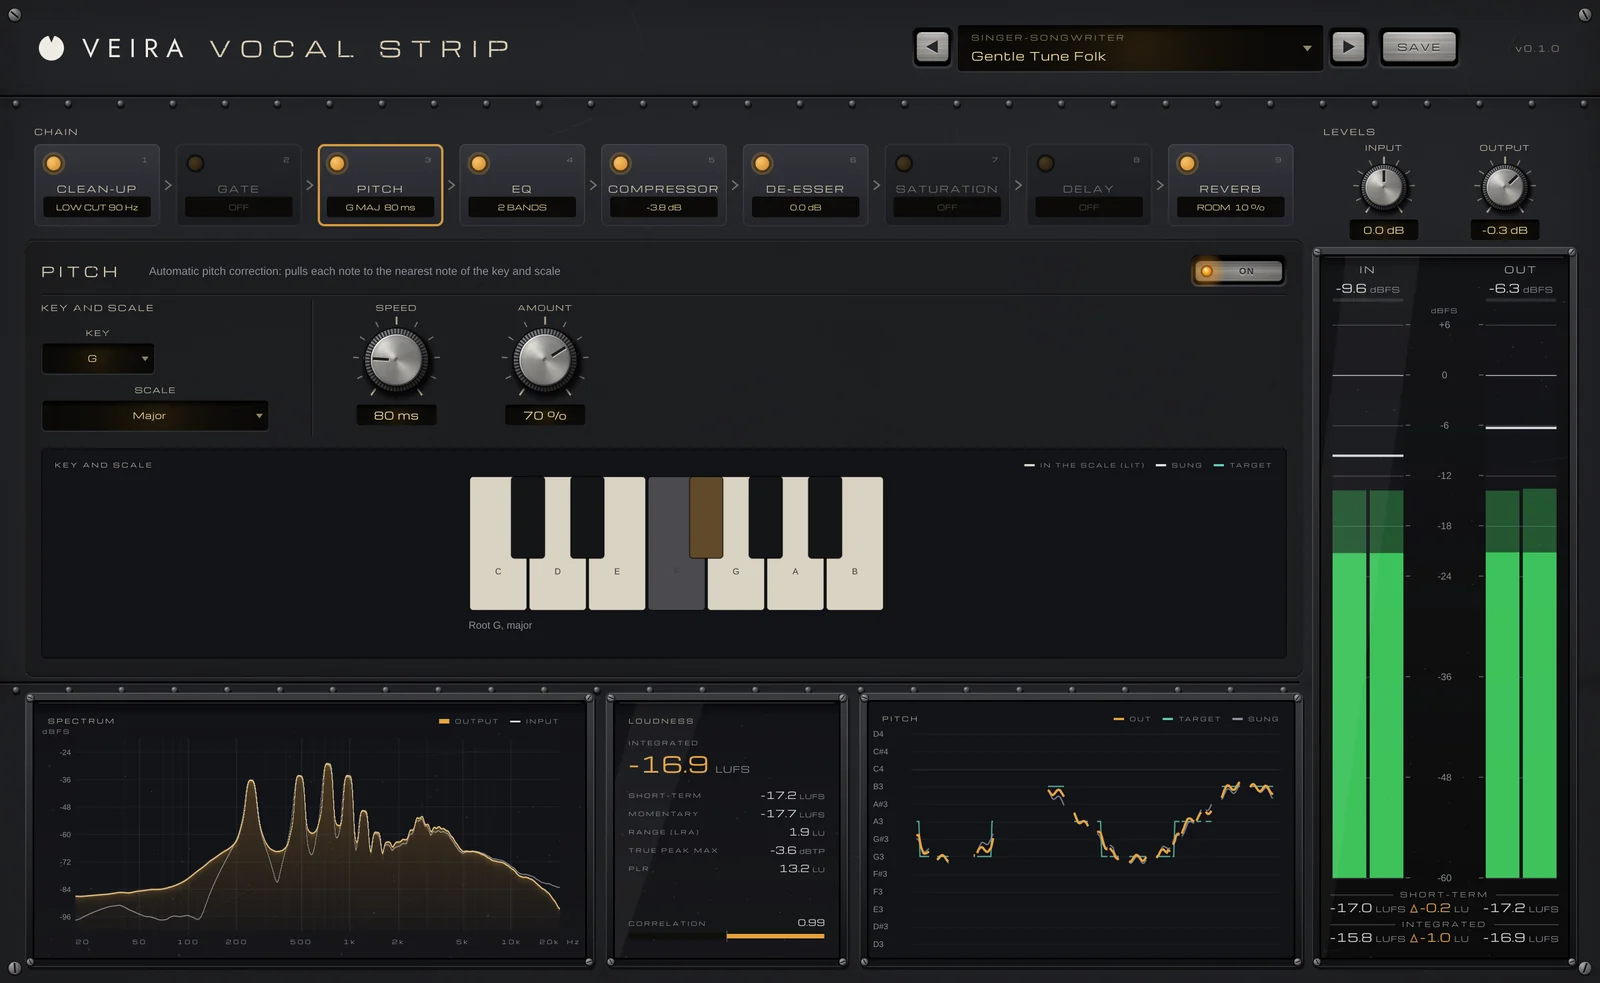
VEIRA Vocal Strip pone toda la cadena en una sola consola: nueve módulos, CLEAN-UP, GATE, PITCH, EQ, COMPRESSOR, DE-ESSER, SATURATION, DELAY y REVERB, en el orden en que normalmente se procesa una voz. Al abrirlo, la tira estándar está encendida: CLEAN-UP, EQ, COMPRESSOR y DE-ESSER. Haz clic en una tarjeta para abrir sus controles, arrástrala para moverla y haz clic en su lámpara para encenderla o apagarla. Un nuevo orden hace un fundido de salida de 15 ms y vuelve a entrar, así que no se oyen clics mientras pruebas las alternativas.

PITCH lleva cada nota a la nota más cercana de KEY y SCALE: un SPEED de 20 a 60 ms es una corrección natural, y 0 ms la ajusta al instante para el efecto duro. El COMPRESSOR mira 2 ms hacia adelante para atrapar el inicio de cada palabra, y su detector ignora lo que está por debajo de 60 Hz, así que los popeos no lo hacen bombear. El DE-ESSER compara la banda de sibilancia con el propio nivel de la voz, así que actúa igual en una toma suave y en una fuerte.
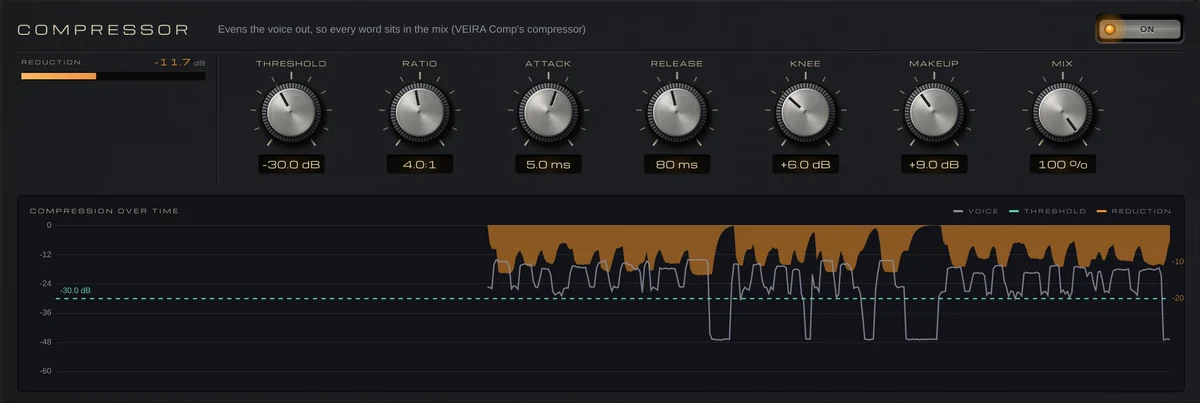
Cada módulo muestra lo que hace en su propia pantalla, y la latencia es de 60 ms constantes a 48 kHz, así que la voz se mantiene a tiempo cambies lo que cambies. Está hecho para mezclar, no para monitorear mientras grabas. Sus 71 presets, en diez carpetas como Pop Vocals, Backing Vocals y Podcast & Voice-Over, traen cada uno una nota que dice qué ajustar primero.