Blog · Mezcla de principio a fin · Parte 11 de 20
De-essing y control de nivel de la voz principal: “s” más suaves y cada palabra audible
Dónde vive la sibilancia y dónde va el de-essing en la cadena, cuánto quitar sin que el cantante cecee, y cómo nivelar palabras y frases con VEIRA Vocal Rider y automatización del fader para que la voz siga al frente toda la canción.
En la parte 10 armamos la cadena de la voz principal: limpieza, ecualización, dos etapas de compresión y un toque de color. Quedan dos trabajos: domar las “s” que la compresión y el brillo hacen subir, y asegurarse de que cada palabra se oiga mientras la canción sube y baja a su alrededor.
De dónde viene la sibilancia
La sibilancia es la ráfaga de ruido de la “s”, la “sh”, la “ch”, la “z” y la “t”, por lo general entre 4 y 10 kHz, las voces más graves hacia la parte baja de ese rango y las más agudas hacia arriba. Los micrófonos cercanos y brillantes, la compresión y cada subida de agudos la hacen más fuerte, y por eso el de-essing funciona mejor al final de la cadena de la voz. Escucha a un nivel moderado buscando la “s” que te hace parpadear, y revisa también con audífonos, donde la sibilancia es más áspera.
Configura VEIRA DeEss
En la parte 10 apagamos el de-essing dentro de la cadena de la voz, así que VEIRA DeEss será la única etapa que escuche las “s”. Insértalo después de toda la cadena (compresión, subida de agudos y color), para que oiga la sibilancia en su peor momento. Y como los inserts van antes de los envíos, hacer de-essing en el canal también limpia lo que los envíos llevarán al espacio que armamos en las partes 14 y 15, donde una “s” salpicada se nota todavía más.
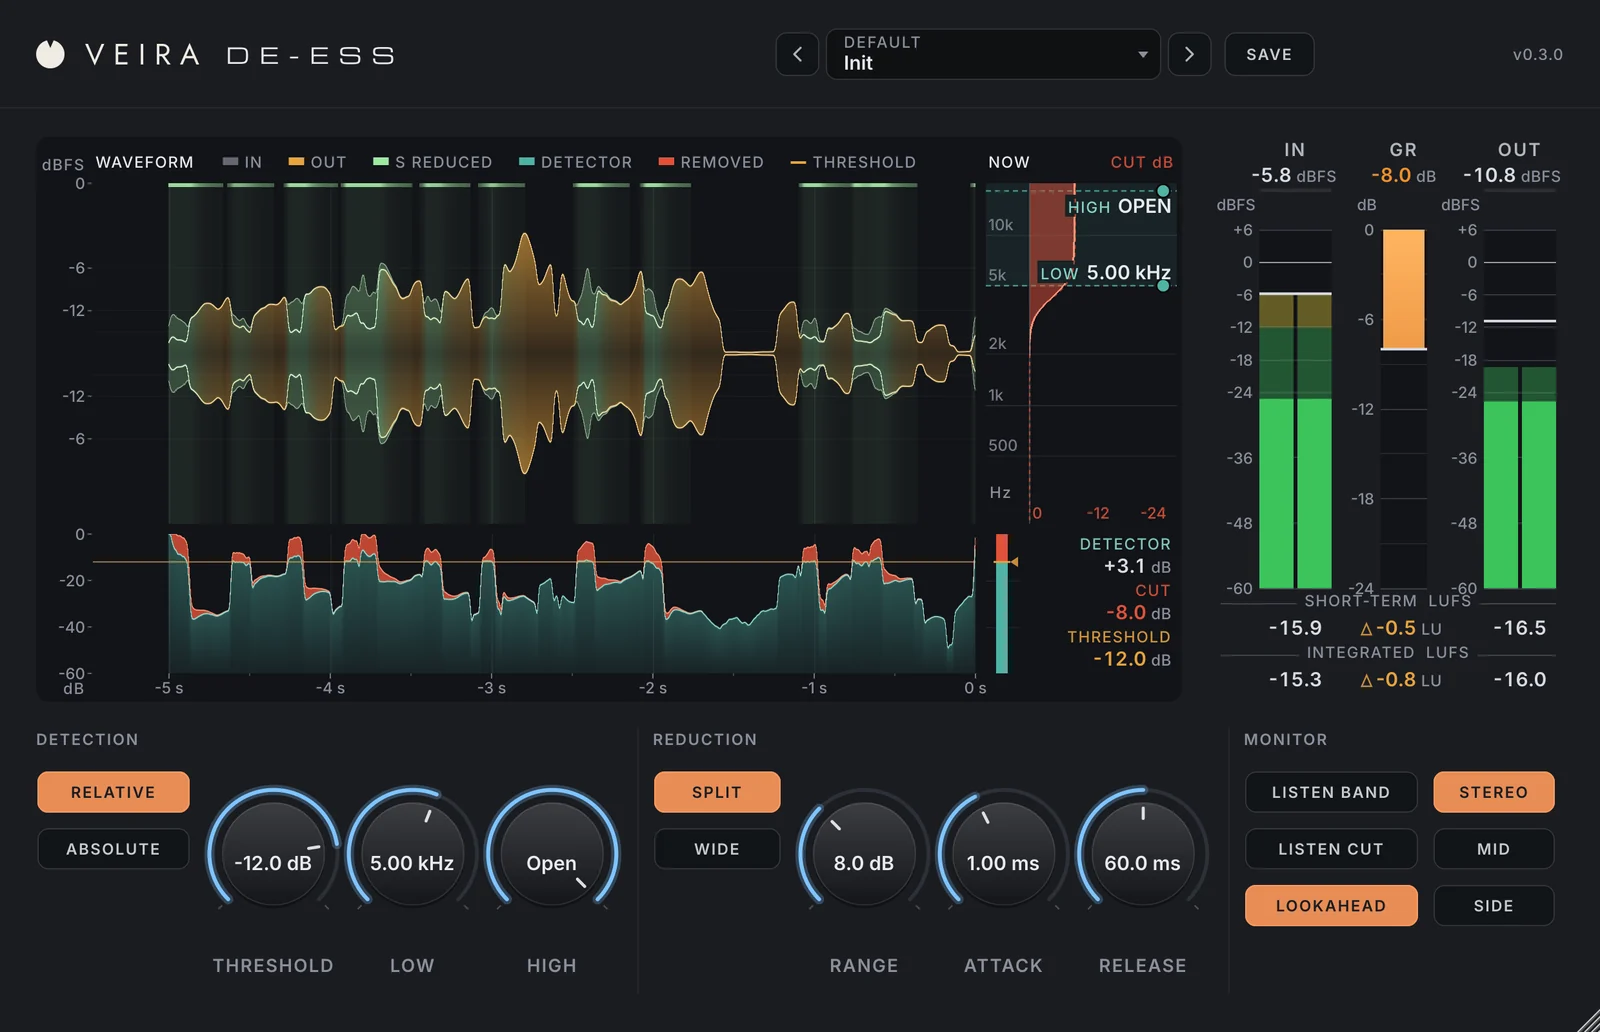
Empieza con la detección Relative: mide la banda aguda frente a la propia voz, así que un solo threshold atrapa las mismas sibilantes tanto si el cantante susurra como si grita, y las respiraciones en las pausas no pueden dispararlo. Para la banda, empieza con LOW entre 5 y 6 kHz para una voz más grave, por lo general masculina, o entre 6 y 8 kHz para una más aguda, por lo general femenina, y HIGH abierto. Luego activa LISTEN BAND, que reproduce lo que oye el detector, y arrastra los puntos LOW y HIGH del panel NOW hasta oír sobre todo “s” y muy poca vocal.
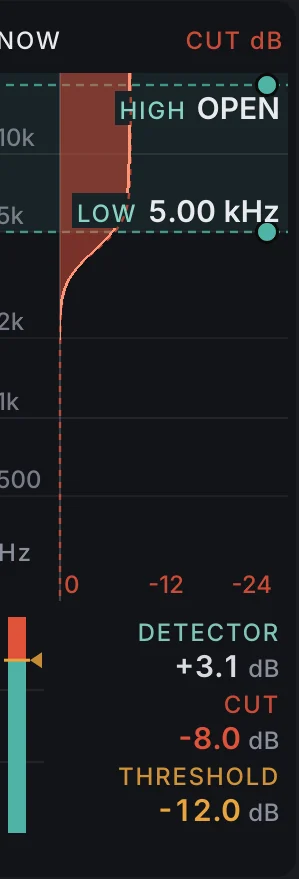
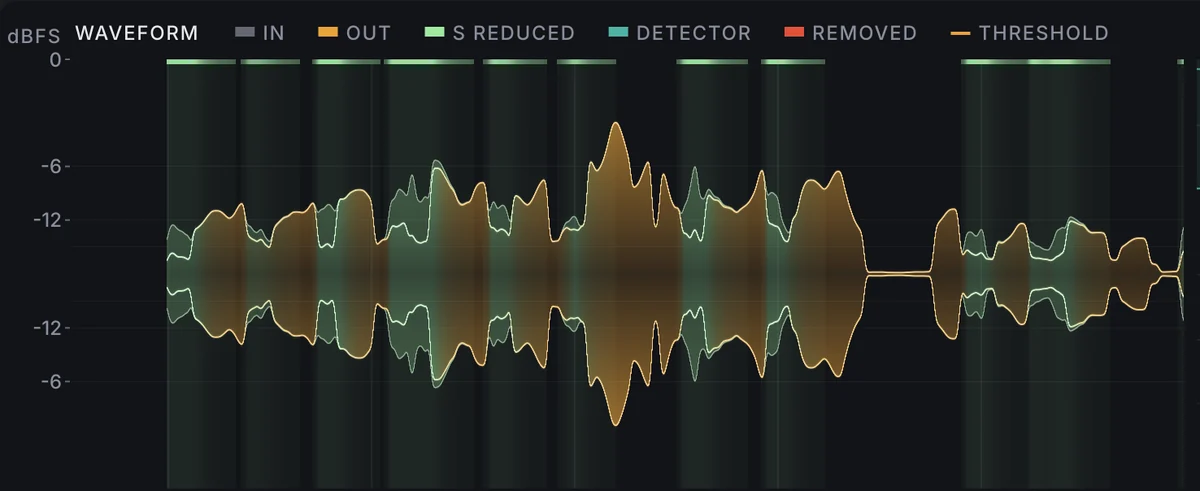
Ahora arrastra la línea ámbar del threshold en el carril del detector hasta que las sibilantes fuertes la crucen y las suaves no, y mira cómo la forma de onda de arriba se vuelve verde claro en cada “s” que recorta. Mantén el corte moderado: 3 a 6 dB en las peores sibilantes suele ser suficiente, y un rango de unos 6 dB evita que vaya más allá. Un attack rápido, de alrededor de 1 ms, y un release de 50 a 100 ms siguen la duración de una “s” sin opacar la vocal que viene después. Split baja solo la banda y deja en paz los armónicos altos de las vocales; Wide baja toda la señal, como un cantante que se aparta del micrófono, y puede sonar más natural en una voz muy brillante.
Demasiado, muy poco
- Demasiado: la “s” se vuelve borrosa, el cantante parece cecear y la voz pierde el aire. Sube el threshold o reduce el rango.
- Muy poco: la “s” sigue saltando en el coro o en parlantes pequeños. Ajústalo en la sección más fuerte, no en la estrofa.
- LISTEN CUT reproduce solo lo que se está quitando. Si oyes vocales ahí, la banda empieza demasiado abajo o el threshold está demasiado hondo.
- Mira el puente de medidores: la diferencia entre salida y entrada debería quedarse cerca de 0 LU, porque solo deberían moverse las sibilantes.
Después juzga en la mezcla completa. Una voz que en solo suena un poco suave en las “s” por lo general suena bien una vez que los platillos y las guitarras están a su alrededor.
Controla el nivel de la voz, palabra por palabra
Incluso después de la compresión, una voz no está pareja frente a la música: una palabra suave al final de una frase desaparece bajo un crash, y una frase del estribillo canta por encima de la banda. Los ingenieros siempre lo han resuelto con una mano en el fader. VEIRA Vocal Rider hace ese trabajo por ti: ajusta TARGET, donde debe quedar la voz en LUFS, y un fader de consola se mueve con suavidad para mantenerla ahí, dentro de RANGE DOWN y RANGE UP. Solo se mueve el nivel; el tono, los transitorios y la respiración quedan como estaban.
Muchos ingenieros lo ponen antes de la compresión, para que la compresión de la parte 10 reciba una entrada pareja y trabaje igual en cada frase. Después de la cadena, justo antes de VEIRA DeEss, también funciona, como un último ajuste de nivel. Prueba ambas y quédate con la que suene más estable.
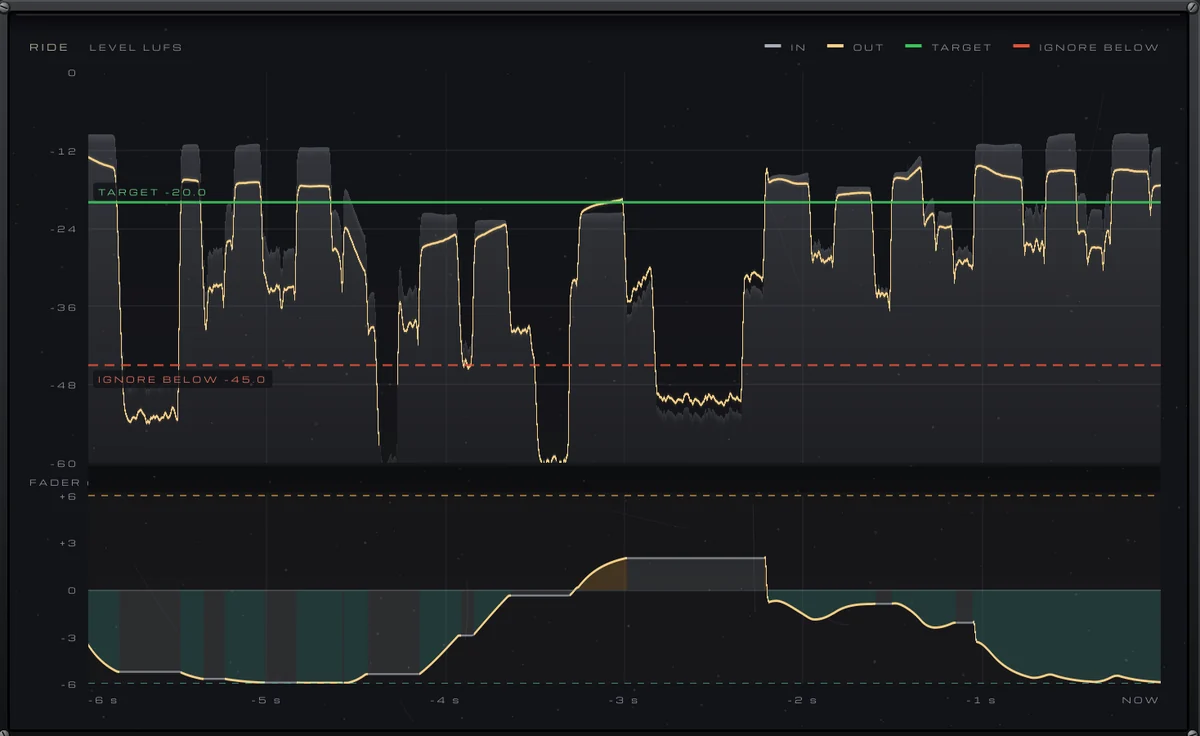
- TARGET: reproduce un pasaje en el que la voz se asiente bien frente a la canción y pon TARGET más o menos en la sonoridad de la voz ahí (por defecto es −20 LUFS). Entonces sube las frases que quedan por debajo y baja las que quedan por encima.
- RANGE DOWN y RANGE UP: los 6 dB por defecto en cada sentido son un buen comienzo; 3 a 4 dB mantienen el ajuste sutil en una toma bien cantada.
- SPEED: los valores bajos siguen frases completas, los altos siguen palabras; el 46 % por defecto queda en el medio. El fader siempre baja el doble de rápido de lo que sube.
- IGNORE BELOW: ponlo por encima de las respiraciones y el ruido de sala entre frases, pero por debajo de las palabras cantadas más suaves, para que el ruido nunca se suba (por defecto es −45 LUFS).
VEIRA Vocal Rider escucha solo entre 100 Hz y 5 kHz, donde está la voz, así que una “s” o una “p” reventada no cuentan como una palabra fuerte, y se queda quieto en las pausas y las respiraciones. LOOKAHEAD le permite oír 25 ms por adelantado, así que una primera palabra fuerte después de un pasaje suave ya está bajada cuando suena; esos 25 ms se informan a tu DAW, que mantiene la voz a tiempo.
Escribe el ajuste y luego hazlo musical
Un ajuste automático te da una voz pareja; uno musical sigue siendo decisión tuya. Cambia a WRITE y reproduce la canción: cada movimiento va al parámetro FADER, así que tu DAW graba el ajuste como automatización, unos 30 puntos por segundo. Luego cambia a READ y edita el carril como cualquier otra automatización. Sube la última palabra de una frase que se cae, baja una respiración que todavía está demasiado fuerte, empuja la voz un decibelio arriba en el último coro. Mantén estos movimientos pequeños, a menudo de 1 a 3 dB, y revísalos frente a la canción, no en solo.
Con la sibilancia bajo control y cada palabra audible, la voz principal está terminada. Lo siguiente, en la parte 12, es armar los coros y los dobles a su alrededor.