Eine Vocal-Kette aufbauen: was zuerst kommt, was zuletzt und warum
Welche Prozessoren ein Leadgesang meist braucht, welche Reihenfolge für die meisten Stimmen funktioniert, warum jeder an seinem Platz sitzt und wann es sich lohnt, die Regel zu brechen.
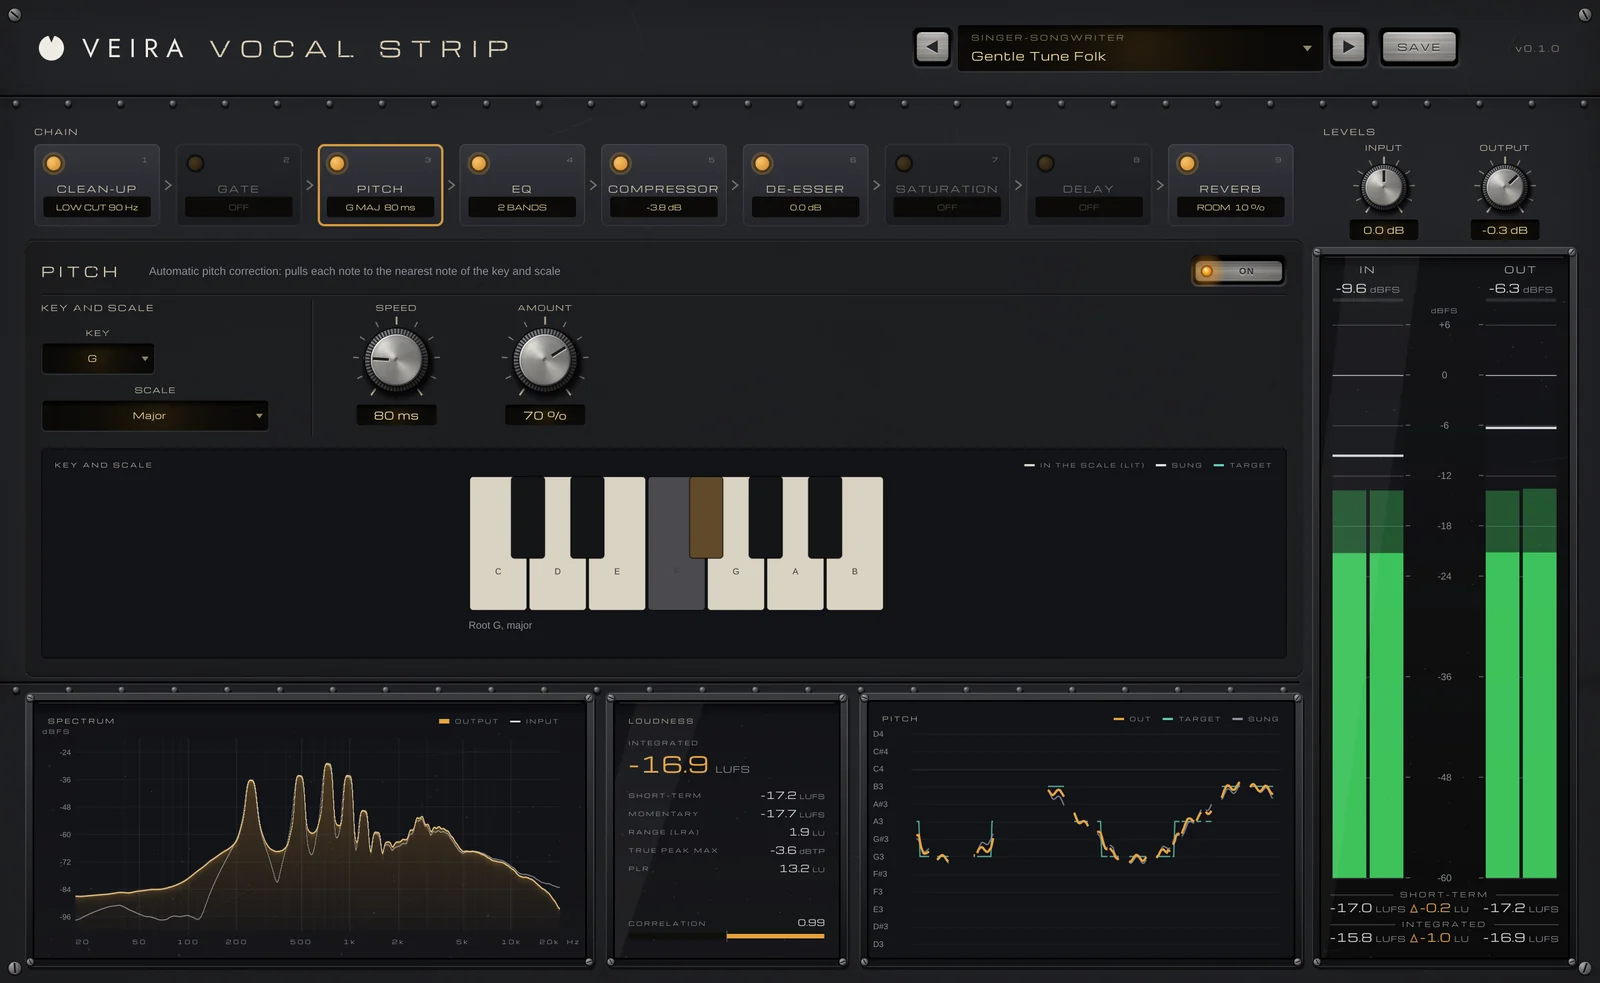
Ein Leadgesang kommt selten mit einem einzigen Prozessor aus. Meist läuft er durch eine kurze Kette: etwas zum Aufräumen, etwas für den Klang, etwas für einen gleichmäßigen Pegel, etwas gegen die „s“-Laute und etwas Raum drumherum. Jeder Prozessor hört, was der vorige getan hat, also verändert die Reihenfolge das Ergebnis genauso stark wie die Einstellungen. Stimmt sie, hat jede Stufe leichteres Spiel; stimmt sie nicht, kämpfst du gegen deine eigene Kette.
Zuerst aufräumen
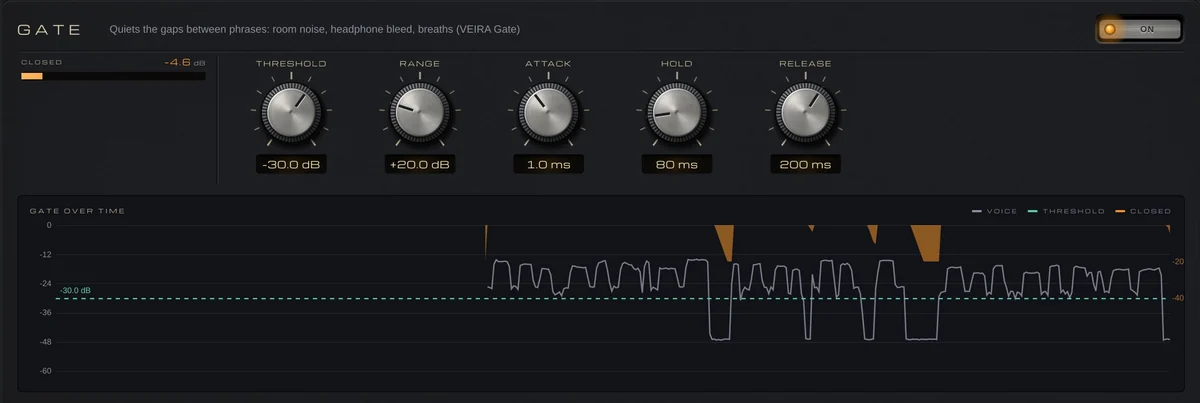
Fang damit an, alles zu entfernen, was nicht die Stimme ist. Ein Hochpassfilter nimmt Rumpeln, Stativklopfer und Popplaute heraus; etwa 80 bis 100 Hz ist für die meisten Stimmen ein üblicher Startpunkt, bei einem tiefen Sänger etwas weniger. Ein Gate oder ein sanfter Expander kann dann Kopfhörer-Übersprechen, Raumgeräusche und laute Atmer zwischen den Phrasen leiser machen. Erledige das vor allem, was Pegel hinzufügt: Ein Kompressor holt die leisen Stellen einer Spur nach oben, und das Rauschen kommt mit.
Stimmen und formen, bevor du komprimierst
Tonhöhenkorrektur funktioniert am besten auf einer sauberen, trockenen Stimme, deshalb kommt sie meist früh, vor allem, was Obertöne, Echos oder Hall hinzufügt. Dann der EQ: Schneidest du Matsch in den unteren Mitten oder eine pappige Resonanz vor dem Kompressor weg, reagiert der Kompressor nicht mehr darauf und arbeitet an den Wörtern statt am Raum. Manche teilen das auf: korrigierende Absenkungen vor dem Kompressor, Präsenz und Luft danach.
Der Kompressor gleicht dann die Performance aus, damit leise Wörter nicht verschwinden und laute nicht herausspringen; ein paar Dezibel Gain Reduction auf den lautesten Phrasen sind ein üblicher Start.
De-Esser nach dem Kompressor
Kompression mit Make-up-Gain hebt alles an, was sie nicht absenkt, auch die Zischlaute, und eine Präsenz- oder Luftanhebung macht sie noch schärfer. Deshalb sitzt der De-Esser meist nach beiden: Er erwischt die „s“-Laute auf dem Pegel, auf dem man sie wirklich hört. Sind die Zischlaute extrem, verhindert ein leichter De-Esser vor dem Kompressor, dass sie auch die Kompression auslösen. Eine typische Kette:
- Aufräumen: ein Hochpassfilter und eventuelle Rauschentfernung.
- Gate oder Expander, um die Lücken zwischen den Phrasen leiser zu machen.
- Tonhöhenkorrektur, solange die Stimme noch trocken und sauber ist.
- EQ: Matsch und Pappigkeit absenken, dann nach Geschmack Präsenz oder Luft hinzufügen.
- Kompression, um die Wörter auszugleichen.
- De-Esser, für die Zischlaute, die Kompressor und EQ angehoben haben.
- Sättigung, für Farbe und Dichte.
- Delay und Hall, am Ende der Kette oder auf Sends.
Farbe und Raum kommen zuletzt
Sättigung nach der Dynamik fügt einem bereits gleichmäßigen Pegel Dichte und Obertöne hinzu, so bleibt der Effekt von Wort zu Wort gleich. Delay und Hall kommen ganz ans Ende oder auf Sends, damit ihre Fahnen nicht vom Kompressor gequetscht oder vom EQ aufgehellt werden.
Wisse, wann du die Regel brichst
Die Reihenfolge oben ist ein Ausgangspunkt, kein Gesetz. Ein EQ nach dem Kompressor lässt deine Anhebungen genau so, wie du sie eingestellt hast; Sättigung davor klingt rauer. Tausch zwei Prozessoren und vergleiche bei gleichem Pegel, denn lauter klingt fast immer erst einmal besser.
So geht es mit VEIRA Vocal Strip
VEIRA Vocal Strip packt die ganze Kette in eine Konsole: neun Module, CLEAN-UP, GATE, PITCH, EQ, COMPRESSOR, DE-ESSER, SATURATION, DELAY und REVERB, in der Reihenfolge, in der eine Stimme normalerweise bearbeitet wird. Beim Öffnen ist der Standard-Strip an: CLEAN-UP, EQ, COMPRESSOR und DE-ESSER. Klick auf eine Karte, um ihre Regler zu öffnen, zieh sie, um sie zu verschieben, und klick auf ihre Lampe, um sie ein- oder auszuschalten. Eine neue Reihenfolge wird über 15 ms aus- und wieder eingeblendet, also gibt es keine Klicks, während du die Alternativen ausprobierst.

PITCH zieht jeden Ton zum nächsten Ton von KEY und SCALE: Ein SPEED von 20 bis 60 ms ist eine natürliche Korrektur, 0 ms rastet sofort ein für den harten Effekt. Der COMPRESSOR schaut 2 ms voraus, damit der Anfang jedes Wortes erwischt wird, und sein Detektor ignoriert alles unter 60 Hz, sodass Popplaute ihn nicht pumpen lassen. Der DE-ESSER vergleicht das Zischlautband mit dem eigenen Pegel der Stimme und arbeitet deshalb bei einem leisen Take genauso wie bei einem lauten.
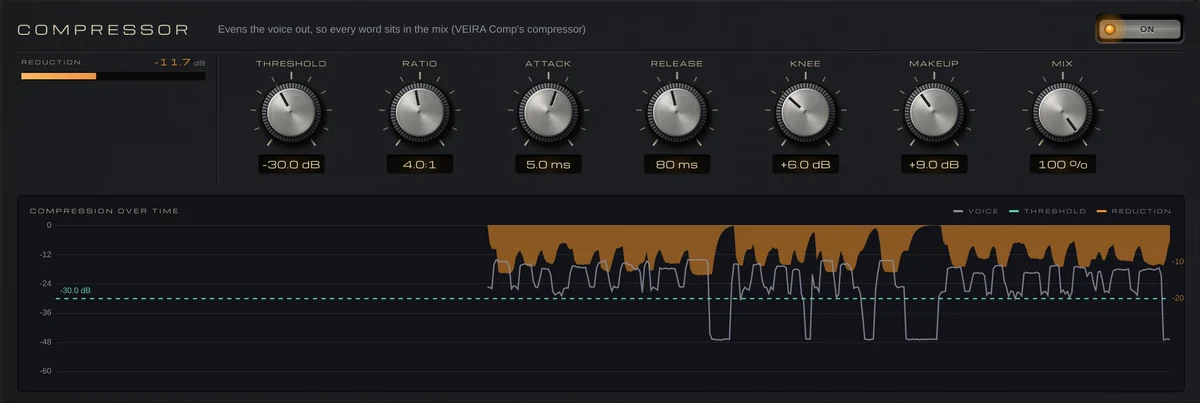
Jedes Modul zeigt in einer eigenen Anzeige, was es tut, und die Latenz beträgt konstant 60 ms bei 48 kHz, sodass die Stimme im Timing bleibt, egal was du änderst. Es ist fürs Mischen gebaut, nicht fürs Abhören während der Aufnahme. Seine 71 Presets in zehn Ordnern wie Pop Vocals, Backing Vocals und Podcast & Voice-Over haben jeweils eine Notiz, was du zuerst einstellen solltest.