Den Gesang mit dem Fader fahren, statt ihn totzukomprimieren
Warum ein Kompressor allein einen Gesang platt machen kann, wie Engineers stattdessen Phrase für Phrase den Fader fahren und wie du Tempo, Bereich und Automation für einen gleichmäßigen, natürlichen Gesang einstellst.
Ein Gesang, der in einer Zeile laut ist und in der nächsten untergeht, gehört zu den häufigsten Problemen im Mix. Die übliche Lösung ist, den Kompressor härter einzustellen, bis die leisen Wörter hochkommen, aber dann hat die Stimme ihre Form schon verloren: Atmer und Raumgeräusche kommen mit hoch, die Konsonanten werden größer und der Klang fängt an zu pumpen. Bevor Kompressoren diesen Job übernahmen, haben Engineers ihn von Hand erledigt: Sie sind den Gesangsfader durch den ganzen Song gefahren. Das funktioniert immer noch, und oft ist es der sauberste Weg zu einem Gesang, der sitzt.
Warum Kompression allein nicht reicht
Ein Kompressor reagiert auf Spitzen, in Millisekunden. Das willst du, um den Anfang eines lauten Worts abzufangen, aber die meisten Pegelprobleme im Gesang sind langsamer: eine ganze Strophe leiser gesungen, eine Refrainzeile aus voller Kehle, ein Sänger, der sich vom Mikrofon wegdreht. Wenn du das mit einem Kompressor lösen willst, brauchst du einen niedrigen Threshold und viel Gain-Reduction, und die Stimme klingt zusammengequetscht. Das Fahren des Faders kümmert sich um die langsamen Unterschiede und lässt dem Kompressor die sanfte Arbeit an den schnellen.
Fahr Phrasen, nicht Silben
Die Idee ist einfach: Entscheide, wo der Gesang gegenüber dem Playback sitzen soll, dann schieb den Fader bei Zeilen, die darunter fallen, ein Stück hoch und bei Zeilen, die herausspringen, ein Stück runter. Gute Fahrten sind klein und weich. Ein paar Dezibel in jede Richtung reichen meistens, und Bewegungen, die der Form einer Phrase folgen, klingen natürlich, während Bewegungen auf jeder Silbe wieder nach Kompressor klingen.
- Stell den Gesangspegel zuerst im wichtigsten Teil ein, oft im Refrain, und fahr den Rest dann passend dazu.
- Fahr etwas schneller runter als hoch: Ein Wort, das heraussticht, stört mehr als eines, das einen Moment zu spät hochkommt.
- Lass die Pausen in Ruhe. Wenn du die Lücken zwischen den Zeilen anhebst, kommen Atmer, Kopfhörer-Übersprechen und Raumgeräusche mit hoch.
- Jag keinen Zischlauten oder Plosiven hinterher: Ein „s“ oder ein geplopptes „p“ kann auf dem Meter laut aussehen, ohne wie ein lautes Wort zu klingen.
- Prüf das Ergebnis bei niedriger Abhörlautstärke, dort hörst du ein untergegangenes Wort am leichtesten.
Miss die Lautheit, nicht die Spitzen
Wenn du den Pegel eines Gesangs beurteilst, zählt, wie laut er klingt, nicht wie hoch seine Spitzen reichen. Lautheitsmesser in LUFS sind so gewichtet, dass sie dem Ohr folgen, und damit eine gute Referenz fürs Fahren: Eine Phrase kann hohe Spitzen haben und trotzdem leise klingen, oder umgekehrt. Ein Short-Term-Lautheitswert auf der Gesangsspur sagt dir mehr darüber, wo jede Zeile sitzt, als ein Peak-Meter.
Halte die Fahrt als Automation fest
Fahrten lassen sich am leichtesten handhaben, wenn sie aufgeschrieben sind. Wenn du sie als Lautstärke-Automation aufnimmst, siehst du jede Bewegung, kannst ein einzelnes Wort anpassen und eine Fahrt rückgängig machen, ohne den Rest anzufassen. Außerdem kannst du so erst fahren und danach komprimieren: Wenn der Pegel schon ausgeglichen ist, muss der Kompressor nur noch die Spitzen abfangen, mit ein paar Dezibel Gain-Reduction statt mit sehr viel.
So geht es mit VEIRA Vocal Rider
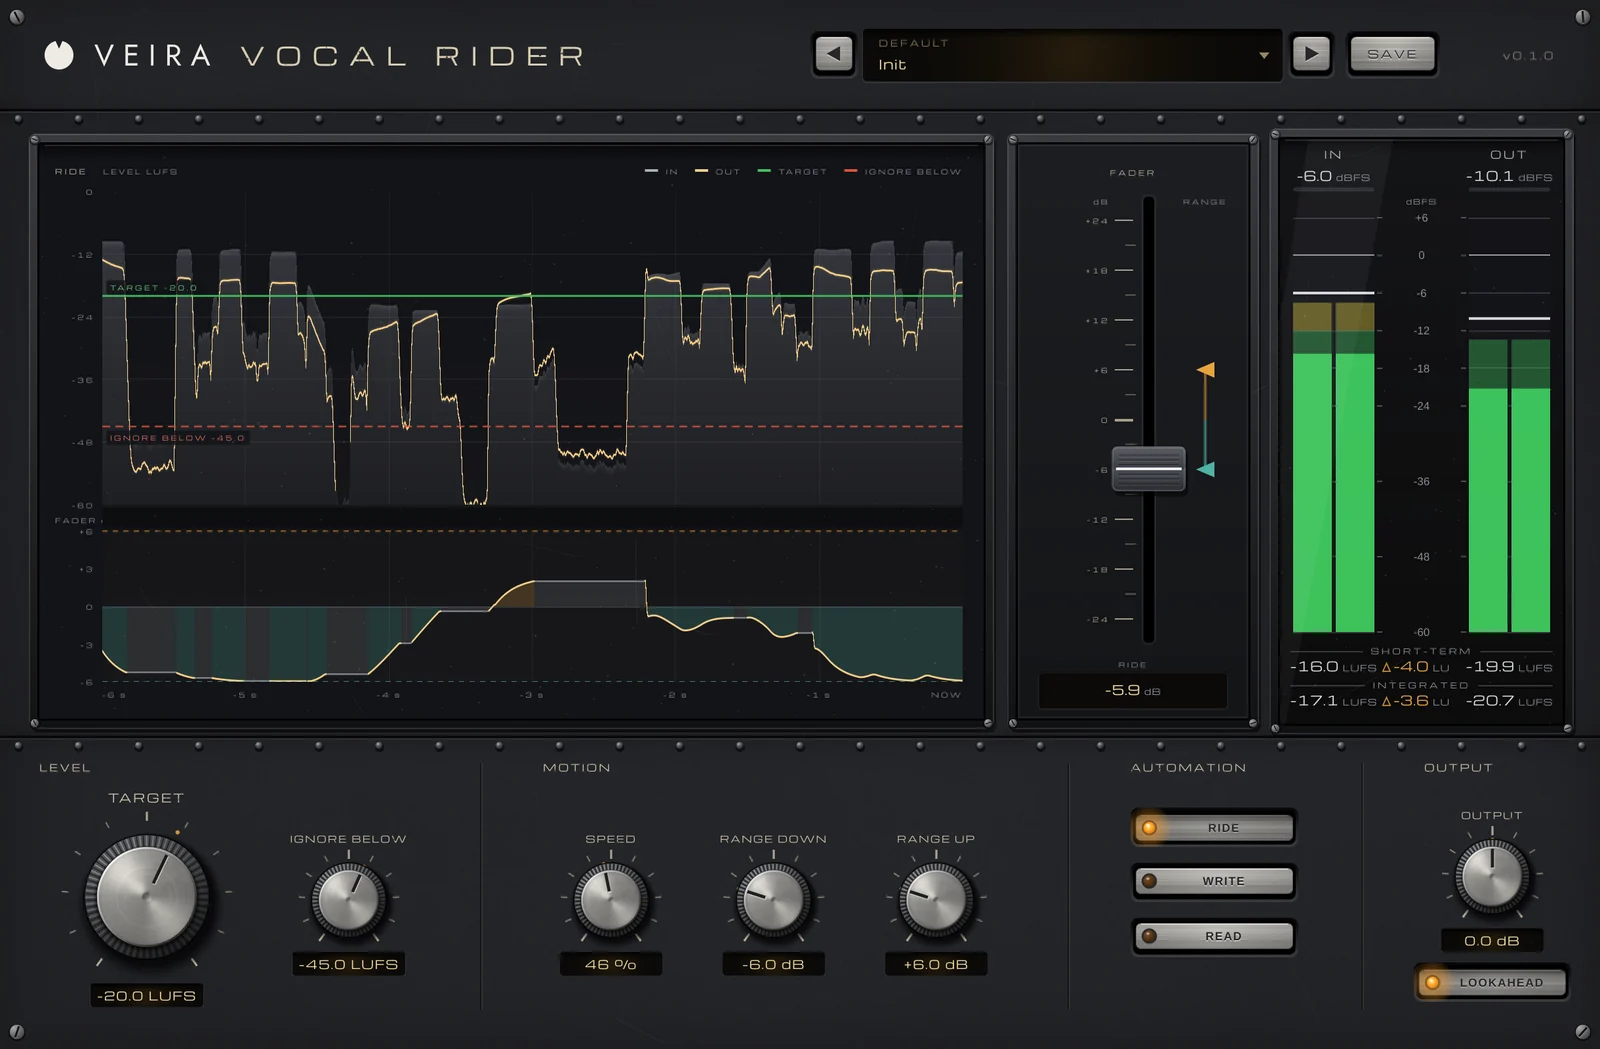
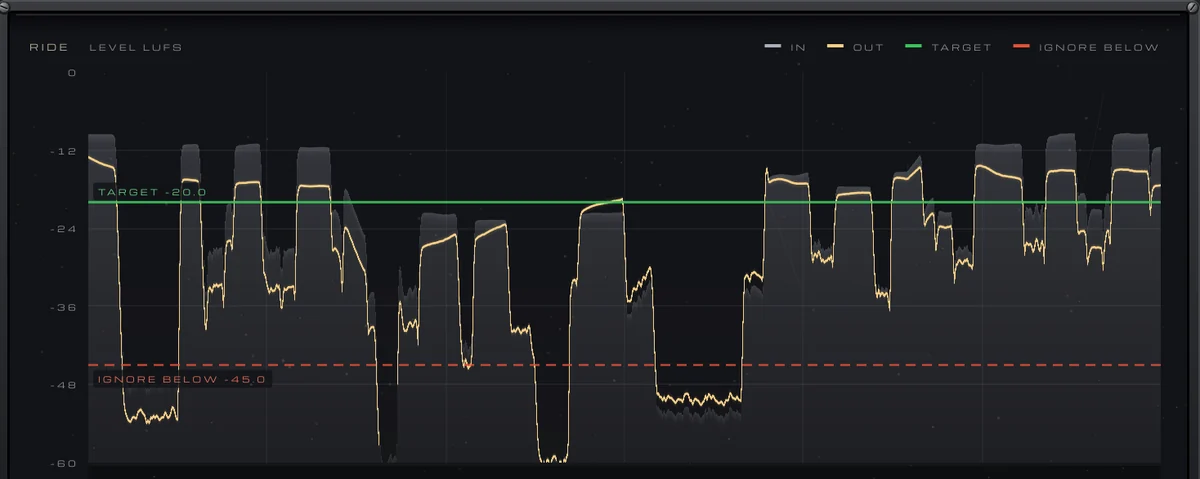
VEIRA Vocal Rider macht, was deine Hand am Gesangsfader macht. Du stellst TARGET ein, wo der Gesang in LUFS sitzen soll, und ein Konsolenfader bewegt sich weich, um ihn dort zu halten, innerhalb von RANGE DOWN und RANGE UP. Er hört die Lautheit K-gewichtet, aber nur zwischen 100 Hz und 5 kHz, wo die Stimme ist, sodass ein „s“ oder ein geplopptes „p“ nicht als lautes Wort zählt, und er bleibt in Pausen, bei Atmern und an Wortenden still stehen. IGNORE BELOW legt den Pegel fest, unter dem er immer still steht.
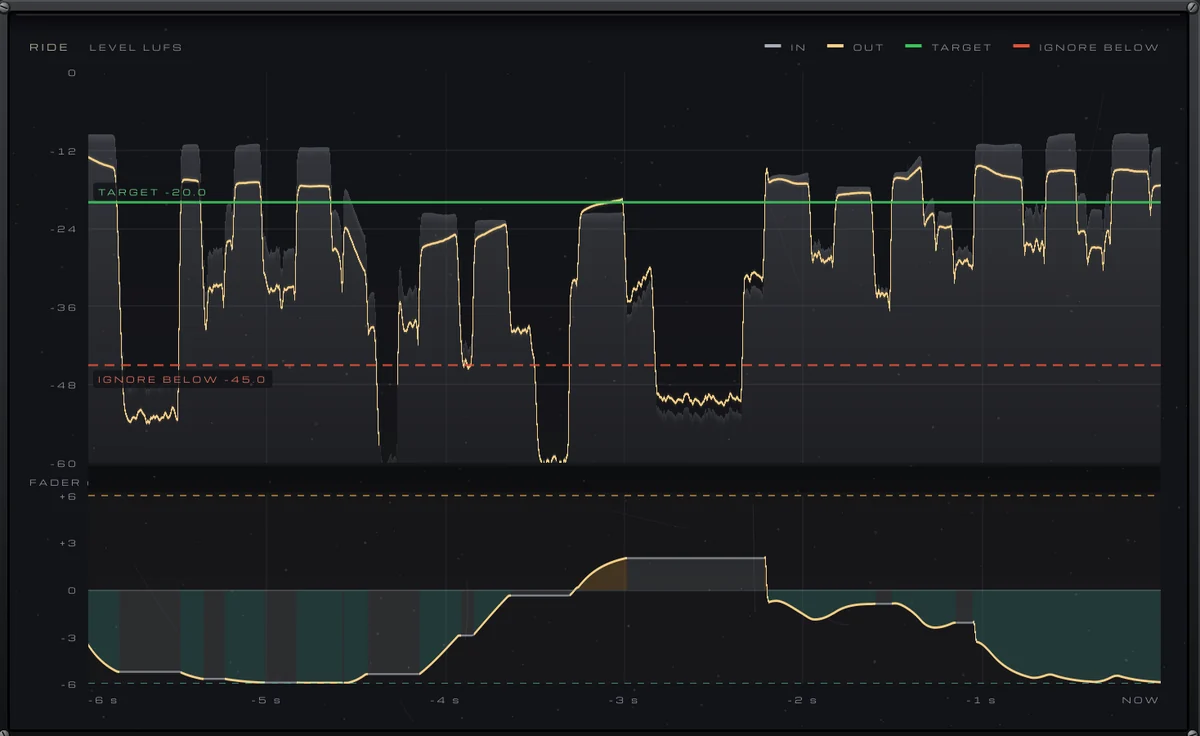
SPEED reicht von einer langsamen Hand, die ganze Phrasen fährt, bis zu einer schnellen, die Wörter fährt, und der Fader fährt immer doppelt so schnell runter wie hoch. Stell RANGE UP oder RANGE DOWN auf 0 dB, und er fährt nur runter oder nur hoch. LOOKAHEAD lässt ihn 25 ms voraushören, sodass ein lautes erstes Wort schon abgesenkt ist, wenn es kommt; die 25 ms werden deiner DAW gemeldet, und beim Aufnehmen kannst du LOOKAHEAD für null Latenz ausschalten.
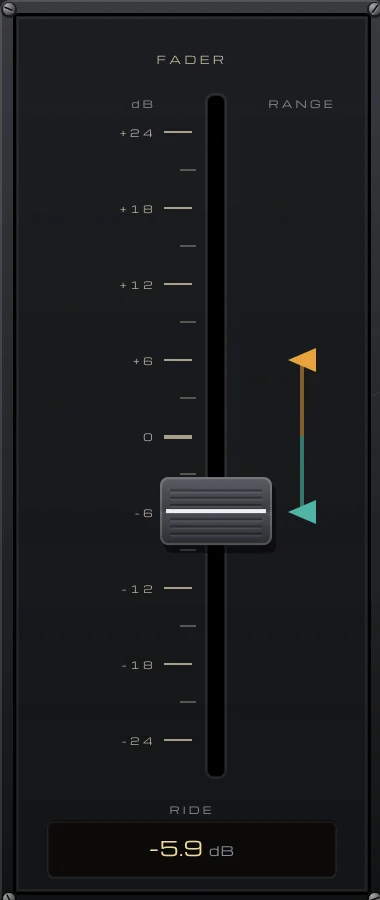
Wenn die Fahrt gut klingt, schickt WRITE jede Bewegung an den Parameter FADER, sodass deine DAW sie als Automation aufnimmt, und READ spielt sie ab, während du den Fader von Hand ziehst, um ein einzelnes Wort zu korrigieren. In den Tests des Plugins lagen Phrasen, die 14 dB auseinander waren, danach innerhalb von 2,1 dB, und Klang und Atmung der Performance bleiben, wie sie waren.